
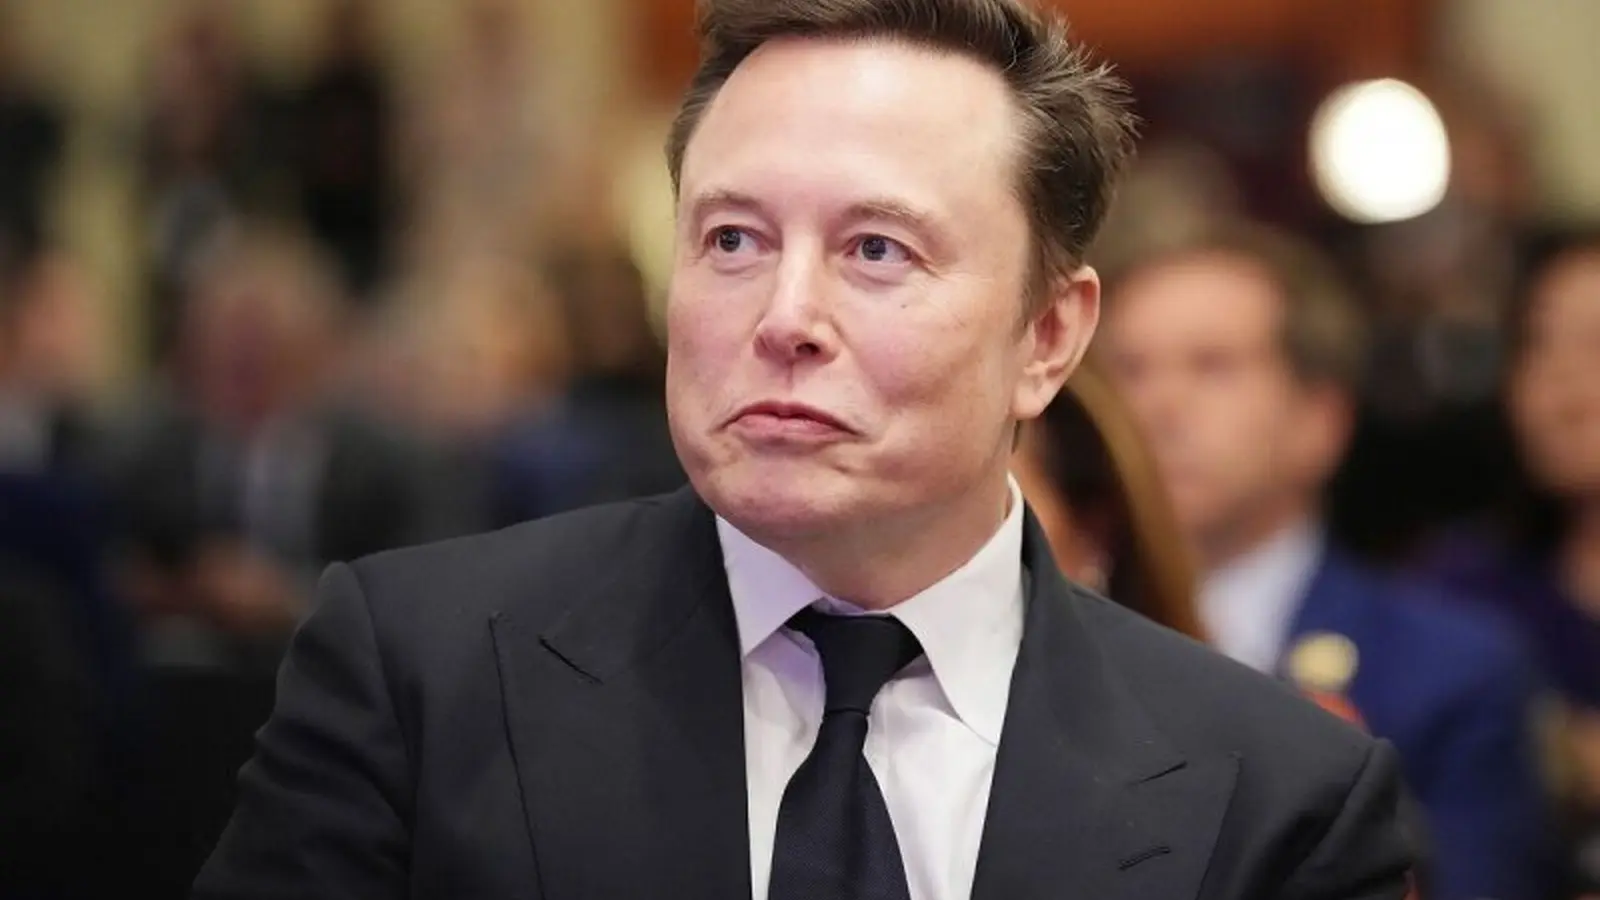
SpaceXAI:n insinöörit laskevat aikaa hiljaiseen mutta merkittävään virstanpylvääseen: kahden biljoonan parametrin neuraalimallin ensimmäinen harjoituskierros päättyy ensi viikolla. Elon Musk vahvisti luvun ja kuvaili päivitystä muuksi kuin pelkäksi numeroiden näytöksi.
Grok 4.5 ansaitsi maineen nopeudesta ja token-tehokkuudesta. Sitä oli edullista käyttää monissa käytännön tehtävissä, mikä teki siitä hyödyllisen myös laboratorioesittelyjen ulkopuolella. Nyt SpaceXAI kertoo, että seuraaja säilyttää tämän operatiivisen säästeliäisyyden kasvattaen samalla raakaskaalaa. Lupaus on kunnianhimoinen: parempi kokonais-suorituskyky ilman tavanomaista viiveen tai token-kustannusten kasvua.
Skalointi kurinalaisuudella
Skalointi tuo usein mukanaan kompromisseja. Suuremmat mallit voivat olla hitaampia ja kalliimpia kyselyissä. Siksi väite, että SpaceXAI:n uusi malli säilyttää Grok 4.5:n token-tehokkuuden, on oleellinen uutinen. Jos väite pitää paikkansa, se kaventaa olennaista aukkoa: miten tarjota korkeampaa kyvykkyyttä kestävin inferenssikustannuksin. Voittaako pelkkä skaala kilpailun? Tavallisesti ei. Mutta skaala yhdistettynä insinööritaitoon, joka säilyttää inferenssin taloudellisuuden, voi siirtää tämän inkrementaalisesta edusta strategiseksi kilpailueduksi.

Musk vihjasi myös, että uusi malli saattaisi ohittaa Kiinan Kimin. Se luo selkeän kilpailukertomuksen, mutta tekninen pointti on tärkeämpi: suorituskyky vertailuissa ja todellisissa tehtävissä, läpimeno kuormituksen alla sekä token-kulutus suuressa mittakaavassa ratkaisevat, kuka lopulta saavuttaa laajemman käytön.
Käytännön käyttäjiä kiinnostavat kolme asiaa: tarkkuus, nopeus ja kustannukset. Grok 4.5 menestyi hyvin kaikissa kolmessa. SpaceXAI:n nykyhanke pyrkii parantamaan tarkkuutta ja kyvykkyyttä samalla kun säilyttää nopeuden ja token-käytön ennallaan. Toisin sanoen älykkäämpi, ei vain suurempi.
Entä mitä tämä tarkoittaa markkinointitekstin ulkopuolella? Nopeammat ja kykenevämmät mallit mahdollistavat monipuolisemmat avustajat, paremman koodin generoinnin ja luotettavamman sisällön ymmärryksen laajassa mittakaavassa. Yrityksille se merkitsee alhaisempaa latenssia asiakasrajapinnoissa ja pienempiä pilvikuluja. Tutkijoille se avaa ovia tutkia emergenttejä käyttäytymismalleja korkeammilla parametrimäärillä ilman lannistavaa laskenta-overheadia.
Tärkein johtopäätös: jos SpaceXAI säilyttää Grok 4.5:n tehokkuuden skaalautuessaan kahden biljoonan parametrin tasolle, alalle syntyy malli, joka on sekä tehokas että käytännöllinen.
Tietenkin lupaukset kohtaavat todellisuuden käyttöönotossa. Lopullinen suorituskyky ilmenee vertaisarvioissa, todellisissa vertailuissa ja siinä, miten malli käyttäytyy erilaisissa kehotteissa ja työkuormissa. Odotettavissa on tarkastelua turvallisuudesta, hallusinaatioiden määrästä ja siitä, miten malli käsittelee pitkän kontekstin päättelyä.
Mitä seurata ensi viikolla: vahvistus siitä, että varsinainen harjoitus on valmis, näytteelliset vertailut, joissa uusi malli asetetaan Grok 4.5:n ja Kimin rinnalle, sekä varhaiset raportit inferenssin latenssista ja token-kulutuksesta tuotantotyyppisissä ympäristöissä. Nämä datapisteet muuttavat rohkean väitteen käyttökelpoiseksi signaaliksi insinööreille, tuote-tiimeille ja tekoälytutkijoille ympäri maailmaa.

"Työskentelen pilvipalveluiden parissa ja kirjoitan Diginissä niiden hyödyistä yrityksille ja yksityisille käyttäjille. Haluan tehdä monimutkaisesta teknologiasta helposti ymmärrettävää."
Keskustelu
Jätä kommentti
Kommentit
Ei vielä kommentteja. Ole ensimmäinen.