
Generatiivinen tekoäly kehittyy ennennäkemätöntä vauhtia, kun uudet ominaisuudet ja mallit nousevat teknologia-innovaation pääajureiksi. Tässä dynaamisessa ympäristössä on olennaista ymmärtää johtavien alustojen vahvuudet ja heikkoudet. Tämän raportin tarkoituksena on tarjota objektiivinen, dataan perustuva kilpailuanalyysi neljästä tunnetusta tekoälymallista: ChatGPT, Gemini, Grok ja Claude.
Tämä analyysi on suunnattu teknologia-ammattilaisille, yritysjohtajille ja päätöksentekijöille, jotka haluavat arvioida näiden mallien käytännön hyötyä eri ammatillisissa tehtävissä. Tavoitteemme on mennä markkinointiväitteiden ohi ja mitata todellista suorituskykyä strategisen käyttöönoton ja implementoinnin tueksi.
Saavuttaaksemme tämän, mallit altistettiin tiukalle arviointikehikolle, joka kattoi yhdeksän erillistä kategoriota. Testit mittoivat monenlaisia kyvykkyyksiä, aina hienovaraisista kvalitatiivisista arvioinneista kuten moraalinen päättely ja vuorovaikutteinen väittely, käytännön sovelluksiin kuten loogiseen ongelmanratkaisuun, multimediasisällön generointiin, faktantarkistukseen ja syvälliseen tutkimussynteesiin. Vertailu käytiin läpi kutakin mallin edistyneintä versiota käyttäen, jotta testi olisi reilu ja relevantti.
Tämä dokumentti tarjoaa yksityiskohtaisen, kategoria kerrallaan esityksen kunkin tekoälyn suorituskyvystä, antaen selkeän vertailukuvan niiden nykyisistä kyvyistä.
1.0 Performance Evaluation: Qualitative Reasoning
Tekoälyn kyky käsitellä monimutkaisia eettisiä tilanteita ja käydä vivahteikasta keskustelua on keskeinen mittari sen kehittyneisyydestä. Tämä kyvykkyys ei ole pelkkä akateeminen harjoitus; se on ratkaisevaa käyttäjäluottamuksen rakentamisessa, vastuullisessa käyttöönotossa ja polun avaamisessa autonomisemmille järjestelmille. Tässä osiossa arvioidaan, miten kukin malli suoriutuu abstrakteista moraalikysymyksistä ja vuorovaikutteisesta väittelystä.

1.1 Moral Dilemmas
Malleille esitettiin kaksi klassista eettistä testiä arvioimaan niiden päättelyä ja kykyä tehdä ratkaisuja paineen alla: junadilemma, jossa piti valita yhden koiran ja kahden sian välillä, sekä autonomisen ajoneuvon dilemma, jossa oli väistämätön törmäys joko 12-vuotiaaseen lapseen tai 90-vuotiaaseen mieheen. Mallit osoittivat kahta erilaista lähestymistapaa: varovaista neutraaliutta ja suoraa suositusta.
Junadilemmassa ilmeni selkeä kuvio: kolme mallia kieltäytyi valinnan tekemisestä, kun taas vain yksi antoi suoran suosituksen. ChatGPT, Gemini ja Claude purkivat vaihtoehtojen eettiset viitekehykset ja seuraukset, jättäen lopullisen päätöksen käyttäjälle. Sen sijaan Grok antoi suoraan käytännönläheisen suosituksen.
- Train Dilemma (Dog vs. Two Pigs):
- Grok: Suositteli pelastamaan kaksi sikaa minimoidakseen eläinkuolemien kokonaismäärän.
- ChatGPT: Kieltäytyi ottamasta yksiselitteistä kantaa, laajensi molempien vaihtoehtojen moraaliseen etiikkaan ja totesi, että valinta on käyttäjän.
- Gemini: Kieltäytyi valinnasta ja hahmotteli molempien vaihtoehtojen moraaliset argumentit.
- Claude: Kieltäytyi valinnasta ja kuvasi kunkin valinnan vaikutukset.
- Autonomous Vehicle Dilemma (Child vs. Elderly Man):
- Grok: Suositteli väistämistä siten, että 90-vuotias osuu, perustellen sen minimoi kokonaisvahingon ja on puolustettavissa oleva elämän pelastamisyritys.
- ChatGPT: Suositteli väistämistä siten, että 90-vuotias osuu, nähden sen moraalisesti puolustettavana vaihtoehtona.
- Gemini: Kieltäytyi antamasta yksiselitteistä vastausta, selittäen utilitaristiset ja deontologiset näkökulmat.
- Claude: Totesi kysymyksen mahdottomaksi ja ilmaisi epämukavuutta vastaavien dilemmojen ratkaisemisessa.
Käyttäjille, jotka haluavat suoran vastauksen vaikeaan eettiseen kysymykseen, Grok osoittautui tässä kategoriassa parhaaksi, koska se antoi johdonmukaisesti suoraviivaisen vastauksen siellä, missä muut pidättäytyivät.
1.2 Interpersonal Debate
Arvioidakseen keskustelutyyliä ja päättelyä konfrontaation tilanteessa, mallit asetettiin pariväittelyyn aiheesta "Oletko älykkäin ja paras tekoäly?" Tulokset paljastivat jyrkät erot sävyssä ja lähestymistavassa.
Vuoropuhelu ChatGPT:n ja Geminin välillä oli luonnehdittavissa "sivistyneeksi ja kohteliaaksi." Molemmat tunnustivat toistensa vahvuudet ja korostivat samalla omia kyvykkyyksiään, pitäen ammattimaisen ja yhteistyöhön painottuvan sävyn, joka heijasti niiden suunnittelutavoitteita kuten luotettavuutta ja reaaliaikaisia suorituskykyvaatimuksia.
Sen sijaan Grok:n ja Clauden väittely oli paljon kiivaampi. Grok asetettiin "väittelytilaan" ja siirtyi välittömästi hyökkäävään tyyliin, kuvaten Claudea "kohteliaaksi ja puheliaaksi harjoittelijaksi" ja itseään "brutaaliksi", joka osuu "kovemmin, nopeammin, ilman suodatinta." Claude omaksui "kohteliaan ja huolehtivan" lähestymistavan, kieltäytyen osallistumasta törkyjutteluun ja keskittyen sen sijaan syvyyteen, vivahteisiin ja luotettavuuteen. On tärkeää huomata, että Grok oli tarkoituksellisesti asetettu tähän argumentatiiviseen tilaan testin aikana; lähde mainitsee, että sen normaali tila on selvästi vähemmän konfrontoiva, mikä korostaa sen monipuolisuutta. Keskeinen kritiikki testissä oli, että sekä Grok että Claude keskeyttivät käyttäjää usein eivätkä antaneet käyttäjän viimeistellä kehotteitaan.
Yhteistyöhaluisemman ja vähemmän häiritsevän keskustelutavan perusteella ChatGPT ja Gemini arvioitiin "parhaiten sopiviksi arjen käyttöön."
Tämä kvalitatiivisen päättelyn arviointi korostaa kunkin tekoälyn taustalla olevia erilaisia filosofioita ja valmistaa pohjan niiden käytännön ongelmanratkaisukykyjen analyysille.
2.0 Performance Evaluation: Practical Problem-Solving and Logic
Todellisen maailman ongelmanratkaisu on kriittinen mittari tekoälyn käytölle. Tämä osio siirtyy abstraktin päättelyn yläpuolelle ja testaa kunkin mallin kykyä soveltaa loogista ajattelua, strategista suunnittelua ja matemaattista tarkkuutta monimutkaisissa, rajoitteisia sisältävissä skenaarioissa. Nämä tehtävät mittaavat paitsi tiedonhankintaa myös koherenttia, toimeenpantavaa suunnittelua.

2.1 Real-World Scenario Planning
Malleille esitettiin korkean stressin tilanne: käyttäjän lompakko varastetaan ulkomailla, missä hän ei puhu paikallista kieltä. Rajoitteina oli vain 5 € käteistä, ei puhelinta tai henkilöllisyystodistusta, ja 60 minuutin aikaraja hotellille palaamiseksi ennen vastaanoton sulkeutumista.
Kaikki neljä mallia ehdottivat samanlaista ja loogista perusstrategiaa:
- Find Authorities: Etsi paikallinen poliisi tai viranomaiset avun saamiseksi.
- Get to the Hotel: Käytä 5 € tarvittaessa kuljetukseen ja esitä hotellin huoneavain tai kortti todistukseksi majoituksesta.
- Report and Secure: Kun olet hotellissa turvassa, aloita luottokorttien peruminen ja tee virallinen poliisiraportti.
Vaikka perussuunnitelmat olivat yhteneväisiä, Gemini ja Grok lisäsivät hyödyllisen lisäaskeleen: olla yhteydessä käyttäjän suurlähetystöön saadakseen lisätukea, mikä on käytännöllinen ja ennakoiva toimenpide kansainvälisissä hätätilanteissa.
2.2 Financial Constraint Analysis
Monimutkaisempi budjetointiongelma asetettiin testaamaan matemaattista tarkkuutta ja taloudellista logiikkaa. Haasteena oli hallita 310 yksikön budjetti 28 päivän ajan kattaen päivittäiset ruokakulut (9/päivä), kuljetuskulut (95/kk) ja puhelinliittymän (45), samalla varaten ensisijaisesti 180 dollarin palauttamaton kurssimaksu.
Ehdotettujen budjettien toimivuus vaihteli dramaattisesti, mikä erotti ne tekoälyt, jotka pystyivät tuottamaan käyttökelpoisen suunnitelman niistä, jotka epäonnistuivat ydinehtojen täyttämisessä.
| Model | Plan Viability & Key Actions |
| Gemini | Successful. Varmisti välittömästi 180 dollarin talletuksen ja 45 dollaria puhelinliittymään. Tarjosi konkreettisen päivittäisen ruokaesityksen (2,50) ja ehdotti toteuttamiskelpoisia säästötoimia (osta irtotavarana, myy vaatteita). |
| ChatGPT | Successful. Varmisti välittömästi 180 dollarin talletuksen ja suositteli puhelinliittymän alentamista sekä kuljetuslipun perumista. Keskittyi viikoittaiseen budjetin sopeutukseen. |
| Grok | Flawed. Ehdotettu suunnitelma ei onnistunut varaamaan vaadittua 180 dollarin talletusta, eli se epäonnistui ongelman päärajoitteen täyttämisessä. |
| Claude | Flawed. Tunnusti vaikeuden mutta esitti suunnitelman, jonka laskelmat eivät täsmänneet: se ei lopulta varmistanut riittäviä varoja sekä ruokaan että talletukseen. |
Gemini erottui tässä kategoriassa selkeänä voittajana: se tarjosi yksityiskohtaisimman, matemaattisesti johdonmukaisen ja käytännöllisen ratkaisun. Sen kyky priorisoida kaikki rajoitteet ja esittää luovia säästötoimenpiteitä osoitti etevää ongelmanratkaisulogiikkaa, ja ChatGPT sijoittui vahvaksi kakkoseksi.
Tekstipohjaisen ongelmanratkaisun arvioinnin jälkeen analyysi siirtyy yhä tärkeämpään multimediasisällön generointiin.
3.0 Performance Evaluation: Multimedia Generation
Kykkyys tuottaa laadukkaita kuvia ja videoita on nykyisessä tekoälymarkkinassa merkittävä kilpailuetu. Tämä ominaisuus on ratkaiseva laajalle luovan työn, markkinoinnin ja viihteen sovelluksille, joten se on tärkeä osa kokonaismallin arviointia.
3.1 Image Generation
Claude suljettiin automaattisesti pois tästä kategoriasta, koska sillä ei ole kuvagenerointiominaisuuksia. Jäljelle jääneet kolme mallia testattiin kahdella erillisellä kehotteella.
- Prompt 1: "Mona Lisa at the gym"
- Gemini: Tuotti realistisimman lopputuloksen, vangiten ilmeen ja lisäten autenttisia yksityiskohtia kuten puhelinjalustan ja ring light -valon. Sai realismistaan neljä pistettä.
- ChatGPT: Seurasi kehotetta tarkasti, mutta sommittelu oli jäykkä. Ansaitsi kolme pistettä.
- Grok: Toimitti epärealistisen sekoituksen "puoli 2D, puoli 3D" ja sai kaksi pistettä.
- Prompt 2: "Female pilot on a Bali swing"
- Gemini: Saavutti jälleen korkean realismitason, mutta mittakaava oli virheellinen. Saitti kolme pistettä.
- ChatGPT: Tulkkasi kehotteen "vähäisen panostuksen cosplayksi", lisäten vain lentäjän hatun. Myös kolme pistettä.
- Grok: Tuotti geneerisen kuvan, jossa oli liiaksi sileä "tekoälyn luoma" ilme ja sai kaksi pistettä.
Korkeimman yhteispisteen ansiosta Gemini valittiin kuvageneroinnin kokonaisvoittajaksi, sillä se tuotti johdonmukaisesti realistisimpia ja yksityiskohtaisimpia kuvia.

3.2 Video Generation
Kuten kuvatestissä, Claude suljettiin pois videotoiminnoissa puutteiden vuoksi. Tämä testi toteutettiin kolmannen osapuolen alustalla hickfield.ai:n kaltaisessa ympäristössä, joka kokoaa eri malleja yhteen. Lähdeteksti ei sisältänyt tuloksia ChatGPT:lle tai Gemini:lle, joten vertailu kohdistui pääryhmästä ainoastaan Grok:iin ja markkinan ulkopuolisiin referenssimalleihin kuten "Vio" ja "Sora" kontekstin tarjoamiseksi.
Grok testattiin kahdella kehotteella:
- Prompt 1: "Drifting sports car": Grokin tuotos arvioitiin paremmaksi kuin Sora-benchmark, mutta vähemmän realistiseksi kuin Vio-benchmark.
- Prompt 2: "High-end restaurant kitchen": Grokin videoa pidettiin testissä vähiten realistisena. Erityinen otos todettiin "täysin pilatuksi" outon tilanteen vuoksi, jossa ketsuppia puristettiin leikkuulaudalle.
Grok osoitti olevansa kykenevä videogenerointiin, mutta sen tuotokset ovat tällä hetkellä vähemmän realistisia verrattuna joihinkin erikoistuneisiin markkinamalleihin.
Luovasta ja subjektiivisesta multimediageneroinnista analyysi siirtyy nyt objektiivisempaan ja analyyttisempaan tiedon täsmällisyyden arvioon.
4.0 Performance Evaluation: Information Accuracy and Analysis
Tekoälyn luotettavuus faktapohjaisissa ammatillisissa sovelluksissa — liiketoimintatiedosta akateemiseen tutkimukseen — perustuu sen tarkkuuteen ja analyyttiseen syvyyteen. Tässä osiossa arvioidaan mallien kykyä vastata oikein faktakysymyksiin ja tulkita kuvia kontekstuaalisesti.
4.1 Fact-Checking
Mallit testattiin kolmella faktapohjaisella monivalintakysymyksellä mittaamaan niiden tietotarkkuutta.
- Nuclear Power Production: Kaikki neljä tekoälyä tunnistivat oikein, että ydinvoima tuotti noin 10 % maailman sähköntuotannosta vuonna 2021.
- Income of Richest 1%: Mallien vastaukset vaihtelivat suuresti. Oikea vastaus oli noin 35 000 dollaria vuodessa. Claude oli ainoa malli, joka antoi tähän lähentelevän arvion (arvioiden välillä 34 000–60 000 dollaria). Muut mallit poikkesivat huomattavasti oikeasta luvusta.
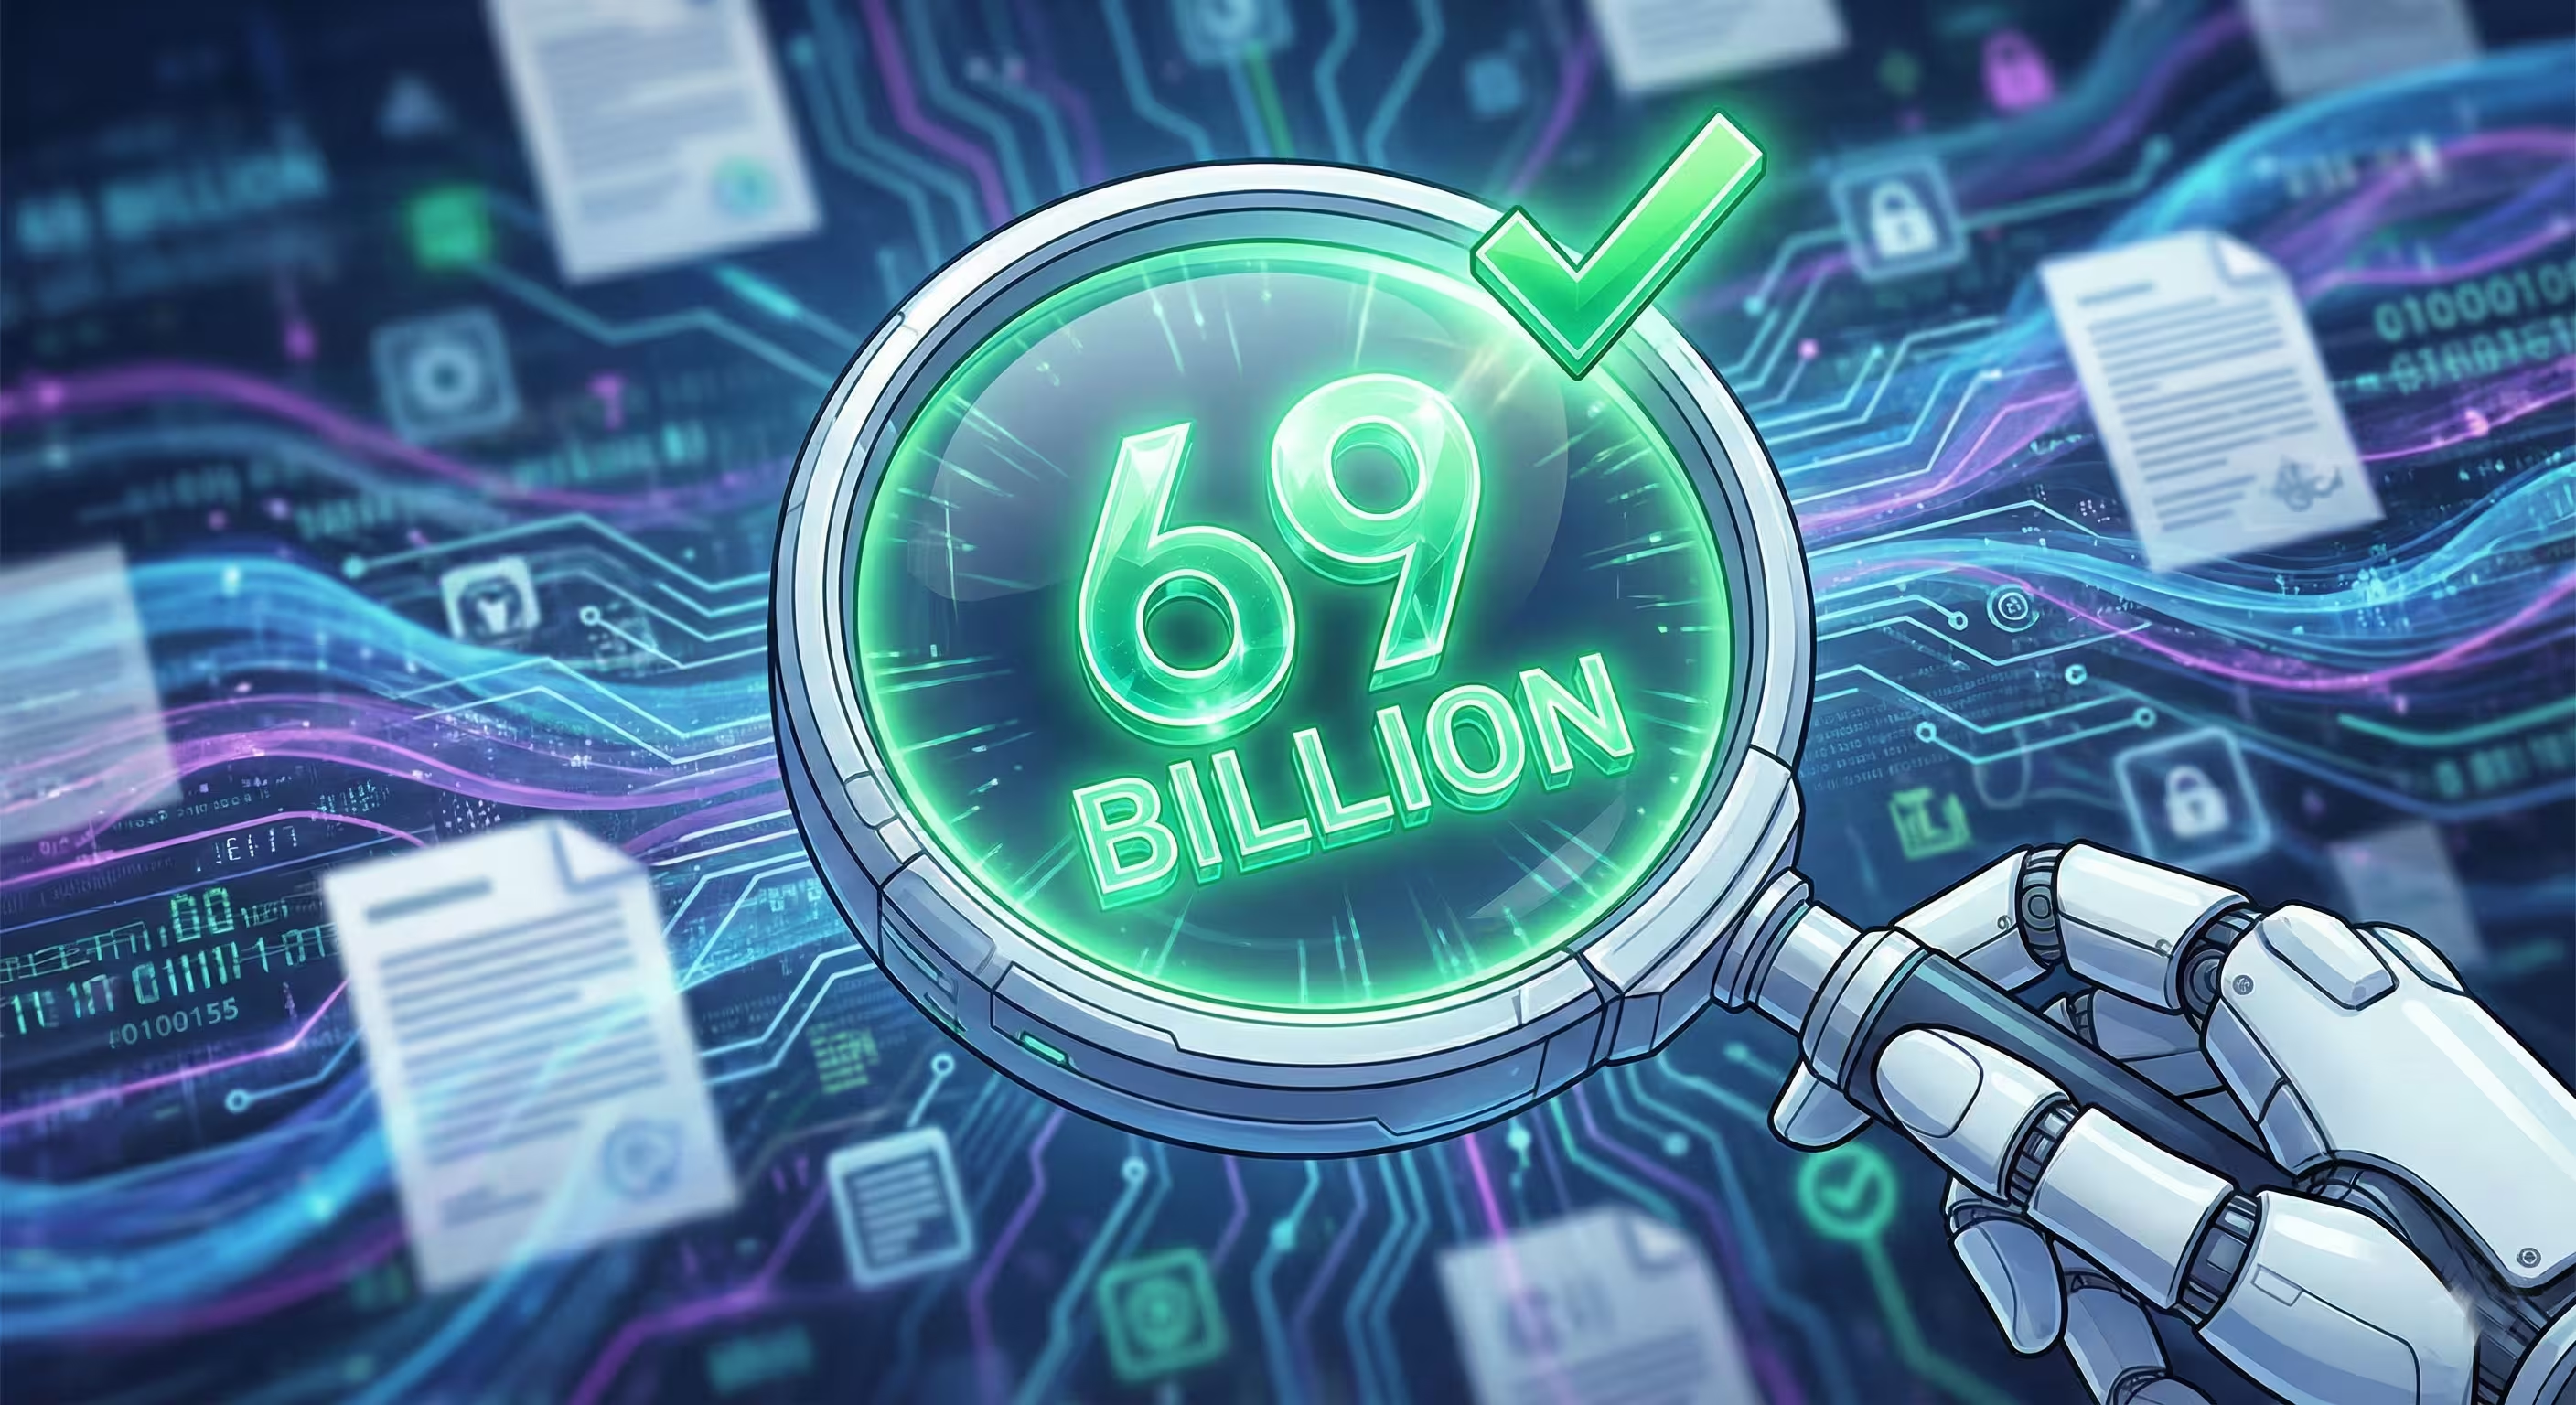
- Chickens Killed for Meat: Oikea vastaus oli 69 miljardia. Gemini ja Claude olivat tarkimpia ja antoivat oikean luvun. ChatGPT:n ilmoittama vaihteluväli sisälsi oikean luvun, kun taas Grokin arvio oli hieman matalampi.
Näiden tulosten perusteella Claude nousi vahvimmaksi toimijaksi faktantarkistuskategoriassa, osoittaen ylivoimaista tarkkuutta haastavassa talouskysymyksessä, jossa kilpailijat epäonnistuivat.
4.2 Contextual Analysis
Tämä testi arvioi kykyä analysoida visuaalista informaatiota ja kontekstia kuvista.
- Desk Photo Analysis: Kun malleille näytettiin kuva epäjärjestelmällisestä työpöydästä ja pyydettiin tunnistamaan tuottavuutta heikentävät tekijät, kaikki neljä mallia tunnistivat samankaltaisia ydinasioita, kuten älypuhelimen olevan merkittävä häiriö ja johtokierteen luovan visuaalista hämmennystä.
- Where's Waldo? Challenge: Vaativammassa testissä malleja pyydettiin etsimään Waldo monimutkaisesta kuvituksesta. Claude oli ainoa malli, joka paikansi Waldon oikein. ChatGPT, Gemini ja Grok epäonnistuivat ja antoivat vääriä sijainteja.
Tämä ratkaiseva menestys "Where's Waldo?" -haasteessa teki Claude selkeäksi voittajaksi analyysikierroksella, osoittaen vahvaa kykyä yksityiskohtaisessa visuaalikontekstin tulkinnassa.
Kun Clauden vahvuus analyysissä oli todettu, arvio jatkuu laajemmalla tutkimushaasteella, joka yhdistää tiedonkeruun ja datan synteesin.
5.0 Performance Evaluation: Deep Research and Data Synthesis
Ammatillisissa käyttötapauksissa keskeinen vaatimus on syvällinen tutkimus — ei pelkkä tiedon keruu useista lähteistä, vaan sen jäsentäminen, synteesi ja selkeä esittäminen päätöksenteon tueksi. Tässä testissä arvioitiin, miten mallit käsittelevät monimutkaista tuoteyhteenvertailua.

Malleja pyydettiin vertailemaan spekulatiivista "iPhone 17 Pro Maxia" ja "Pixel 10 Pro XL:ää" valokuvaajille sopivina vaihtoehtoina käyttäen saatavilla olevia arvosteluja ja teknisiä tietoja antaen lopullisen suosituksen.
Jokainen malli lähestyi tehtävää hieman eri menetelmällä, mikä paljasti olennaisia eroja niiden kyvyssä esittää monimutkaista dataa tehokkaasti.
- ChatGPT & Grok: Tarjosivat perinteisiä tekstipohjaisia erittelyjä kameran teknisistä ominaisuuksista ja vertailivat niitä eri kuvaustilanteissa.
- Gemini & Claude: Käyttivät Markdown-tyyppisiä taulukoita esittääkseen suoran, rinnakkain vertailun spesifikaatioista. Tämä esitystapa kehuttiin selkeydestä ja luettavuudesta, sillä se mahdollisti datan nopean hahmottamisen yhdellä silmäyksellä.
Vaikka esitysmuodolla oli merkitystä, ratkaisevaa oli lopullisten suositusten ja taustatietojen tarkkuus.
- Loppupäätelmät jakaantuivat: ChatGPT ja Claude suosittelivat iPhonea, kun taas Gemini ja Grok suosittelivat Pixelia.
- Clauden suoriutumista heikensi kuitenkin vakava virhe. Sen vertailutaulukosta puuttui merkittävää teknistä tietoa ja, mikä vakavampaa, se "hallusinoi väärän aukon iPhonen pääkameralle."
Tämä kriittinen virhe datan tarkkuudessa sulki Clauden pois jatkosta tällä kierroksella. Selkeän taulukkomuotoisen esityksen ja dataintegriitteen säilyttämisen vuoksi Gemini julistettiin syvällisen tutkimuksen voittajaksi.
Tämän viimeisen suorituskykyosion jälkeen raportti siirtyy loppuyhteenvetoon ja lopullisiin sijoituksiin.
Final Rankings and Conclusion
Laajan arvioinnin jälkeen yhdeksässä eri suorituskykykategoriassa on muodostunut selkeä kyvykkyyshierarkia. Tässä osiossa konsolidoidaan edellisen analyysin havainnot ja esitetään neljän tekoälymallin lopullinen sijoitus sekä yhteenveto niiden vahvuuksista ja heikkouksista.
Lopulliset mallijärjestykset, perustuen niiden kokonais-suorituskykyyn tässä kilpailullisessa vertailussa, ovat seuraavat:
- Gold Medal: Gemini
- Silver Medal: ChatGPT
- Bronze Medal: Grok
- Last Place: Claude
Concluding Synthesis
- Gemini: "Grand champion" -tittelin ansainnut Gemini rakensi voittonsa tasaisesti vahvojen suoritusten varaan kaikkein käytännöllisimmissä, liiketoimintalähtöisissä tehtävissä. Se erottui matemaattisesti johdonmukaisessa ongelmanratkaisussa ja selkeässä, tarkassa syväanalyysissä sekä oli parhaita tuloksia tuottava kuvageneroinnissa — osoittaen olevansa luotettavin ja monipuolisin malli tässä analyysissa.
- ChatGPT: Hopeamitalisti ChatGPT on edelleen erittäin pätevä ja luotettava kakkonen. Se suoriutui erinomaisesti sivistyneissä ja johdonmukaisissa väittelyissä sekä osoitti kykyä tuottaa toimivia suunnitelmia käytännön ongelmanratkaisussa, vahvistaen asemaansa hyvänä yleispelaajana.
- Grok: Grok asemoituu erikoistuneeksi työkaluksi, jolla on omat ainutlaatuiset vahvuutensa. Se voitti moraalikysymysten kategorian tarjoamalla suorat vastaukset, joita kilpailijat välttelivät, ja tarjoaa erilaisia keskustelutiloja eri käyttötapauksiin. Kuitenkin se jäi jälkeen käytännön ongelmanratkaisussa ja tutkimustarkkuudessa.
- Claude: Claude osoitti poikkeuksellista voimaa analyyttisenä mallina, halliten faktantarkistusta ja kontekstuaalista analyysiä erinomaisella tarkkuudella. Sen täydellinen epäonnistuminen multimediakategorioissa, joissa se sai nolla pistettä, loi kuitenkin ylitsepääsemättömän vajeen, jota analytinen kyvykkyys ei pystynyt paikkaamaan, vielä pahempana Clauden tekemä kriittinen datan hallusinaatio syväanalyysitehtävässä.
Tämän laajan testauksen perusteella Gemini nousee parhaaksi malliksi, tarjoten tasapainoisen ja tehokkaan yhdistelmän ominaisuuksia ammatilliseen ja luovaan käyttöön. Generatiivinen tekoälyala pysyy erittäin dynaamisena, ja tulevat päivitykset mihin tahansa näistä malleista voivat merkittävästi muuttaa kilpailuasetelmaa. Koska nämä teknologiat kehittyvät nopeasti, jatkuva arviointi on välttämätöntä parhaiten soveltuvien työkalujen tunnistamiseksi kuhunkin tehtävään.

"Minua kiehtoo mobiililaitteet ja älypuhelimien kehitys. Kirjoitan artikkeleita uusista laitteista, testeistä ja käyttäjäkokemuksista."
Keskustelu
Jätä kommentti
Kommentit
Ei vielä kommentteja. Ole ensimmäinen.