

Yhdistetyn Marylandin yliopiston ja Microsoftin tutkimuksen odottamaton löydös: puolan kieli suoriutui paremmin kuin 25 muuta kieltä suurten tekoälymallien ohjeistamisessa (promptointi), kun taas englanti sijoittui vain kuudenneksi. Tämä tulos herättää kysymyksiä siitä, miten kielivalinta, tokenisaatio ja kieliopilliset piirteet vaikuttavat mallien tuottaman sisällön tarkkuuteen ja laatuun.
Miten tutkijat testasivat kielten suorituskykyä tekoälyssä
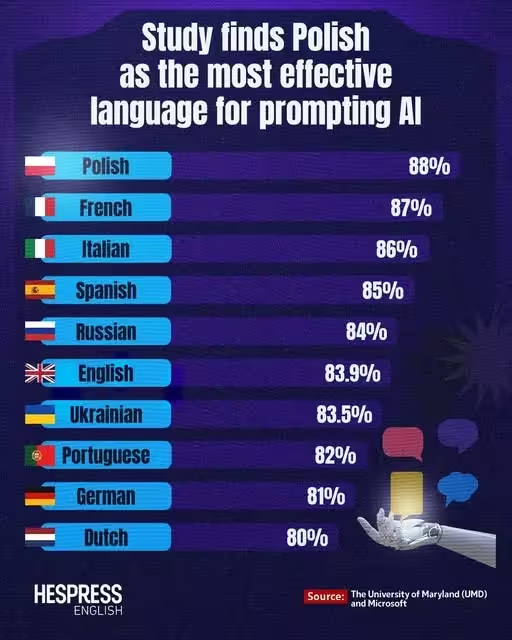
Tutkijaryhmä syötettiin identtiset ohjeet, jotka oli käännetty 26 kielelle, useille suurille kielimalleille — mukaan lukien OpenAI:n mallit, Google Gemini, Qwen, Llama ja DeepSeek — ja mitattiin tehtävien tarkkuutta erilaisilla arviointimetriikoilla. Kokeissa käytettiin sekä lyhyitä että pitkiä tekstipohjaisia tehtäviä, vaikeusaste vaihdellen faktatiedonhankinnasta ja päättelystä dialogin hallintaan. Odotuksista poiketen puolan kieli sijoittui kärkeen keskimääräisellä tehtävätarkkuudella 88 %.
Menetelmässä kiinnitettiin huomiota siihen, että käännökset olivat semanttisesti mahdollisimman yhdenmukaisia lähdetekstin kanssa: sama prompt-arkkitehtuuri, sama kysymyksen asettelu ja vastaavalla pituudella tuotetut esimerkit eri kielillä. Arvioinnissa hyödynnettiin automaattisia metriikoita sekä ihmisarviointia, jotta mallivastausten laatu ja relevanssi voitaisiin mitata monipuolisesti. Tutkijat raportoivat, että vaikka jotkin mallit näyttivät oppivan kielen spesifisiä tapoja paremmin, kokonaiskuvassa kielen rakenteellisilla piirteillä oli merkittävä vaikutus tuloksiin.
Raportin kirjoittajat luonnehtivat tuloksia "odottamattomiksi" ja korostivat, ettei englanti ollut yksiselitteinen voittaja. Pitkän tekstin arvioinneissa englanti sijoittui kuudenneksi, kun taas puola oli parhaana kokonaisuudessaan. Tämä havainnollistaa, että kielivalinta voi konkreettisesti muuttaa mallin tuotoksen laatua — erityisesti kun tavoitteena on korkea tarkkuus, ohjeiden selkeys ja vähäinen epävarmuus vastauksissa.
AI-prompttien parhaat kielet — tutkimuksen tuloslista
Tässä ovat tutkimuksen kymmenen parasta kieltä keskimääräisen tarkkuuden mukaan järjestettynä. Lista näyttää, että eri kielten välillä on vain pieniä prosenttiyksiköiden eroja, mutta erot ovat toistuvia eri tehtävätyypeissä ja malleissa:
- Puolan kieli — 88%
- Ranska — 87%
- Italia — 86%
- Espanja — 85%
- Venäjä — 84%
- Englanti — 83,9%
- Ukraina — 83,5%
- Portugali — 82%
- Saksa — 81%
- Hollanti — 80%
Miksi puola saattaa olla parempi AI-promptteihin?
Useita teorioita voi selittää tämän intuitiivisesti yllättävän tuloksen. Ensinnäkin puolan kieli on morfologisesti rikas: se käyttää taivutuksia, joissa sanojen muodot kantavat paljon kieliopillista informaatiota. Tämä voi johtaa siihen, että tokenisaatiomekanismit (esimerkiksi BPE eli byte-pair encoding, unigram- tai SentencePiece-pohjaiset tokenizerit) tuottavat tokeneita, jotka linjaavat hyvin transformer-pohjaisten mallien sisäisiin yksiköihin. Kun tokenit vastaavat kielen rakenteellisia yksiköitä tehokkaasti, malli voi tulkita ohjeet tarkemmin, vaikka puolan esimerkkidataa olisi vähemmän kuin englannin kohdalla.
Toiseksi kirjoitusasu ja oikeinkirjoituksen säännöt voivat vaikuttaa: puolassa on suhteellisen johdonmukaiset ortografiset säännöt verrattuna joihinkin kieliin, mikä voi vähentää tokenisaation aiheuttamaa hajontaa ja virhetaajuutta. Kun tokenisaatio on stabiili ja vähentää hajautumista sanamuodoissa, malli saa siistimmän ja yhtenäisemmän syötteen, mikä parantaa ohjeen ymmärrettävyyttä. Tämä on erityisen relevanttia suuropeisissa malleissa, jotka käsittelevät syötteet token-jonoina, ei merkkijonoina.
Kolmanneksi lauseopin ja muodon ilmaisu voivat vähentää moni- tai kaksiselitteisyyttä: joissain kielissä tietyt käsitteet vaativat eksplisiittisiä morfologisia merkkejä, joita ei ole esimerkiksi englannissa. Tällaiset eksplisiittiset kieliopilliset signaalit auttavat mallia tunnistamaan intentiotarkoituksen ja vastaamaan vähemmän arvaillen. Tutkimus antaa myös ymmärtää sen, että kieli, joka on ihmisten näkökulmasta "vaikea" oppia, ei välttämättä ole vaikea tekoälylle — mallit löytävät strukturaalisia kuvioita datasta riippumatta ihmiskielen omaksumisen vaikeudesta.
Lisäksi tokenisaatio- ja sanastointivalinnat eri mallien koulutusvaiheessa voivat suosia tiettyjä kieliopillisia rakenteita. Esimerkiksi jos tokenisaatiota on optimoitu kattamaan laaja valikoima morfeemeja, taivutusmuotoja ja yhdyssanoja, malli voi yleistää paremmin kahdenlaisiin kieliin. Tämä voi osaltaan selittää, miksi kieliä kuten ranskaa tai italiaa seuraavat hyvin; ne myös sisältävät omat morfologiset piirteensä, jotka tokenisoituvat suotuisasti useissa mallityypeissä.
On myös muistettava datan laatu ja lähteet: vaikka englanninkielistä dataa on määrällisesti eniten, sen heterogeenisyys (eri tyylilajit, transkriptioiden laatu, käännösten vaihtelevuus) voi joskus haitata suoraa yleistämistä tietyntyyppisissä ohjeissa. Toisaalta vähemmän runsaan kielen korkea laatuinen ja johdonmukaisesti anotettu data voi tarjota puhtaamman oppimisindikaattorin mallille.
Vastaavasti kiinan kieli sijoittui testeissä lähelle pohjaa (neljäs viimeinen), mikä osoittaa, että suuri koulutusdatan määrä ei yksin takaa parempaa prompt-suorituskykyä eri kielissä. Tokenisaatiohaasteet, eri kirjoitusjärjestelmät (logogrammit) ja datan fragmentoituminen eri teemojen välillä voivat heikentää tuloksia, vaikka datamäärä on suuri.
Vaikutukset prompt engineeringiin ja monikieliseen tekoälyyn
Mitä kehittäjien, tutkijoiden ja prompt-engineerien pitäisi tästä päätellä? Tutkimus antaa käytännöllisiä suosituksia ja herätteitä, jotka liittyvät mallin arviointiin, monikielisiin vertailuihin sekä tuotantoon vietävien järjestelmien validointiin.
- Älä oleta, että englanti on aina paras: testaa ohjeita useilla kielillä — saatat saada tarkempia tai tiiviimpiä vastauksia odottamattomalla kielellä. Tämä on tärkeää erityisesti kun pyritään maksimoimaan tietyn tehtävän suorituskyky tai vähentämään väärinymmärryksiä.
- Ota huomioon morfologia ja tokenisaation vaikutukset suunnitellessasi monikielisiä vertailuja tai hienosäätödataset-arkkitehtuureita. Tokenisointistrategian valinnat (BPE vs. unigram vs. bytemap) voivat muuttaa huomattavasti mallin herkkyyttä eri kielille.
- Kansainvälisissä käyttöönotossa arvioi mallin käyttäytyminen kohdekielillä sen sijaan, että extrapoloisit englanninkielisistä testeistä. Käytä kielen spesifejä benchmarkkeja ja ihmisarviointia varmistaaksesi luotettavan tuotantotason suorituskyvyn.
Lisäksi prompt-optimoijat voivat kokeilla erilaisia phrasing-tekniikoita, kuten eksplisiittisiä tehtäväkehyksiä, roolikomentoja (role prompting), tai esimerkkipohjaista few-shot-menetelmää eri kielillä. Systemaattinen A/B-testaus eri kielillä paljastaa usein, että pienet muokkaukset sanajärjestykseen tai morfologisiin piirteisiin johtavat merkittäviin muutoksiin mallin vasteiden laatuun ja luottamustasoon.
Puolan patenttivirasto (Polish Patent Office) julkaisi jopa sosiaalisessa mediassa, että tulokset osoittavat puolan kielen olevan tarkin kieli tekoälyn ohjeistamiseen, lisäten samalla kuivakan huomautuksen: ihmiset saattavat pitää puolan kieltä vaikeana oppia, mutta tekoäly ei jaa samaa rajoitetta. Vaikka tämä sosiaalinen kommentti on humoristinen, se nostaa esiin vakavan pointin: organisaatioiden tulisi ottaa huomioon kielen erityispiirteet ja testata malleja laajasti ennen päätöksiä monikielisistä käyttöönotosta.
Mitä seuraavaksi?
Tutkijat korostavat, ettei kyseessä ole lopullinen totuus — tarvitaan lisätutkimusta tokenisaation, koulutusdatan jakautumisen ja kielirakenteen vaikutuksista mallien käyttäytymiseen. Tulevat tutkimussuunnat voivat sisältää systemaattisia kokeita, joissa verrataan eri tokenisaattoreita samaan datasettiin, sekä kontrolloituja kokeita, joissa koulutusdatan määrää ja laatua manipuloidaan kielen mukaan. Myös mallin arkkitehtuurin hienosäätö ja pretrainingin kielikohtaiset painotukset ovat lupaavia tutkimusalueita.
Lisäksi käytännön kehittäjät hyötyvät toistettavista benchmarkeista, jotka kattavat sekä lyhyet että pitkät tekstitehtävät (short-form ja long-form promptit), eri tyylilajit (faktapohjaiset, argumentatiiviset, luovat) ja monitasoisen arvioinnin (automatisoidut metriikat ja ihmisarviointi). Yhdistämällä kvantitatiiviset mittarit, kuten tarkkuus, F1 ja BLEU/SARI, laadullisiin arvioihin voidaan rakentaa vankempi ymmärrys siitä, miksi ja milloin tietty kieli tuottaa parempia tuloksia promptoinnissa.
Lopuksi tämä tutkimus kannustaa AI-yhteisöä kyseenalaistamaan oletukset ja laajentamaan kokeilualustaa: monikielinen optimointi, tokenisaatiotestaus ja kielen morfologisten piirteiden huomioiminen voivat antaa kilpailuetua sovelluksille, jotka vaativat tarkkaa, luotettavaa ja monikielistä vuorovaikutusta — kuten juridiset sovellukset, terveydenhuollon tukijärjestelmät ja kansainväliset palvelut.

"Työskentelen pilvipalveluiden parissa ja kirjoitan Diginissä niiden hyödyistä yrityksille ja yksityisille käyttäjille. Haluan tehdä monimutkaisesta teknologiasta helposti ymmärrettävää."
Keskustelu
Jätä kommentti
Kommentit
Ei vielä kommentteja. Ole ensimmäinen.