

Google'n uusi Ironwood-TPU‑perhe on herättänyt uudelleen hiljaisen kilpailun tekoälylaitteistossa: tällä kertaa todellinen haastaja Nvidialle ei ole AMD tai Intel, vaan Googlen oma räätälöity piiri, joka on optimoitu inference- eli päätelmätyökuormille. Suuret muistimäärät, tiheät väylät ja kunnianhimoiset energiatehokkuuslupaukset muovaavat sitä, miltä pilvipohjainen tekoäly näyttää laajassa mittakaavassa.
Ironwood numeroina: muisti, laskenta ja skaalautuva SuperPod
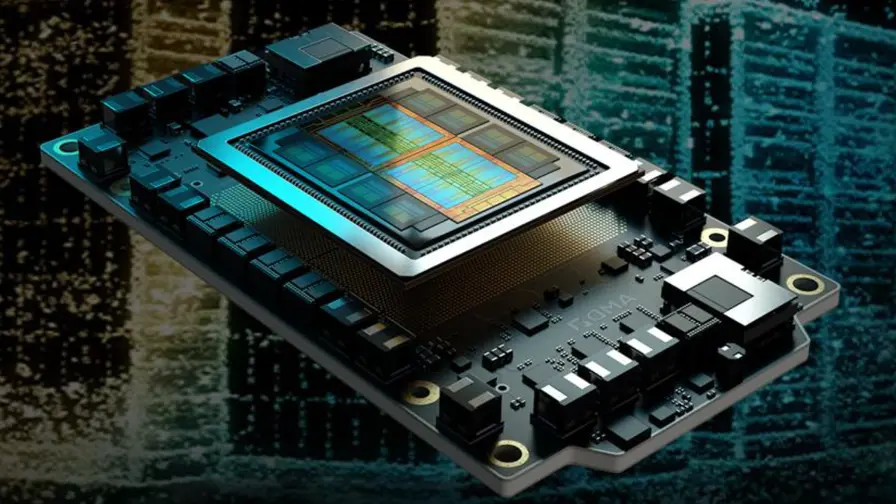
Ironwood (TPU v7) on suunniteltu ydinmääritykseltään yhteen asiaan — mallien palveluun tuotantokäytössä. Google markkinoi sitä "inference-first" -piirinä, jonka ominaisuudet on mitoitettu pienentämään latenssia, alentamaan energian kulutusta per kysely ja yksinkertaistamaan suurten kielimallien sekä reaaliaikaisten AI-palveluiden käyttöönottoa ja ylläpitoa.

- Huippu FP8-laskenta per piiri: ~4 614 TFLOPs
- Pakettiin integroitu muisti: 192 GB HBM3e (noin 7–7,4 TB/s kaistanleveys)
- Podin skaalautuvuus: jopa 9 216 piiriä per SuperPod
- Kokonaislaskenta per pod: ≈42,5 exaFLOPS (FP8)
- Järjestelmän HBM per pod: ~1,77 PB
Nämä kovat numerot ovat tärkeitä, mutta yhtä merkittävä kertomus koskee sitä, miten piirien välinen viestintä on suunniteltu. Google hyödyntää InterChip Interconnect (ICI) -väylää ja 3D-torusverkkorakennetta yhdistääkseen suuren määrän piirejä yhtenäiseksi SuperPodiksi. Tämä scale-up -arkkitehtuuri yhdistettynä 1,8 PB:n inter-pod -verkkoon mahdollistaa suurten mallien pitämisen nopeasti saavutettavassa muistissa sen sijaan, että painot liikutettaisiin hitaampien linkkien kautta.
Tämä arkkitehtuurinen valinta korostaa muistisyvyyden ja siirtonopeuden merkitystä inferenssissä: mitä enemmän mallin parametreja voidaan pitää lähellä laskentaresursseja HBM-muistissa, sitä vähemmän tarvitaan hitaita verkonsiirtotoimia, mikä laskee latenssia ja parantaa läpimenoa. Pilvi-infrastruktuurissa, jossa jonot ja vasteaika ovat bisnekselle kriittisiä, tällaiset erot voivat näkyä suoraan käyttö- ja ylläpitokustannuksissa.
Miksi inference muuttaa kilpailukenttää
Aikaisemmin koulutus (training) oli taistelukenttä: brutto TFLOPs, valtavat muistikokonaisuudet ja optimoidut kernelit määrittelivät kilpailun, ja Nvidia GPU:t hallitsivat tätä aluetta. Nyt tekoälyn talousmalli on muuttumassa. Kun mallit on koulutettu, oikea työkuorma ovat miljardit inferenssikyselyt — eivät enää itse koulutuskierrokset. Tämä asettaa etusijalle latenssin, kyselyläpäisyn, energian kulutuksen per kysely ja kustannustehokkuuden.

Ironwood on suunniteltu näiden mittareiden ympärille. Suuri on-package-muisti vähentää piirien välistä kommunikointia suurten mallien kohdalla, mikä laskee latenssia ja parantaa determinististä vasteaikaa. Googlen mukaan Ironwood tarjoaa merkittäviä sukupolvieroja suorituskyvyssä ja energiatehokkuudessa — yritys kertoo noin 2× parannuksista edellisiin TPU-sukupolviin nähden. Hyperskalaajille ja pilvipalvelun käyttäjille, jotka maksavat jatkuvasta inference-kapasiteetista, tällainen energiatehokkuus voi tarkoittaa huomattavia kustannussäästöjä pitkällä aikavälillä.
Lisäksi Ironwoodin optimointi inference-tyypin laskennalle, FP8-tuen laajuus ja muistin läheisyys tekevät siitä houkuttelevan vaihtoehdon yrityksille, joiden vaatimuksena on suuri läpimeno ja matala pyyhkäisyä toimittava latenssi. Käytännössä tämä tarkoittaa nopeampia vasteaikoja palveluille kuten chatbotit, reaaliaikainen puheentunnistus ja personoitu suosituslogiikka, joissa jokainen millisekunti ja energiajoule lasketaan.
On kuitenkin tärkeää huomata, että inference-optimointi ei poista tarvetta monipuoliselle laskennalle. Koulutusvaiheen monipuoliset työkuormat, retraining ja tutkimus- ja kehitystyö jäävät vahvasti GPU-alueen vahvuuksien piiriin. Siksi tulevaisuus todennäköisesti tarkoittaa heterogeenisiä järjestelmiä: GPU:t, TPU:t ja muut erikoistuneet ASICit toimivat yhdessä sopivimman laskentavälineen mukaan.
Interconnectit, SuperPodit ja ekosysteemilukkiutuminen
Toinen kilpailuetu on integraatio. Tarjoamalla Ironwoodin Google Cloudin kautta Google voi optimoida koko pinoa — laitteiston, verkot ja runtime-ympäristön — alentamaan kustannusta per kysely. SuperPod-lähestymistapa, jossa on tiheä interconnect ja scale-up -kuitu, on suunniteltu palvelemaan erittäin suuria malleja vähemmillä suorituskykyseuraamuksilla verrattuna hajautetumpaan GPU-klusteriin.

Tällainen vertikaalinen integraatio nostaa strategisia riskejä Nvidialle. Vaikka Nvidia tuottaa omia Rubín-räkkejä ja B200 Blackwell -GPU:ita, jotka on suunniteltu inferenceen, pilviasiakkaat saattavat valita natiivin TPU-infrastruktuurin, jos se todellisuudessa laskee latenssia ja käyttöä vastaavia kustannuksia. Tällainen valinta voi vahvistaa asiakaslukkiutumista tiettyyn pilvitoimittajaan ja vähentää yleistä portabiliteettia, etenkin kun asiakkaiden sovellukset on optimoitu tietylle laitteisto- ja ohjelmistopinolle.
Ekosysteemin näkökulmasta huomioitavaa on myös ohjelmiston tuki, kirjastoetujen taso ja kehittäjäyhteisön käyttäytyminen. Vaikka TPU:illa on oma ohjelmistopinonsa (kuten XLA ja TensorFlow-optimoinnit), laaja avoimen lähdekoodin työkalusto ja NV:n CUDA-ekosysteemi tarjoavat vastapainoa. Käytännössä monet organisaatiot valitsevat hybridin: koulutus GPU:illa ja inference TPU:illa, tai hyödyntävät molempia tarpeen mukaan, mikä korostaa orkestroinnin, mallin pakkaamisen ja versionhallinnan merkitystä.
Jensen Huang on huomannut
Nvidian toimitusjohtaja on julkisesti myöntänyt, kuinka vaikeaa räätälöityjen ASIC-piirien kehitys on, ja hän on tunnistanut TPU:t merkittäväksi kilpailijaksi. Tällainen tunnustus ei ole triviaalia: kun markkinajohtajat julkisesti nimeävät vastustajan uhkaksi, se yleensä merkitsee fokusoitua investointia ja kiihtyneitä tuotekierroksia molemmin puolin. Tämä voi nopeuttaa innovointia interconnect-tekniikoissa, ohjelmistooptimoinneissa ja kustannusrakenteissa.
Lisäksi kilpailun kiristyminen voi johtaa siihen, että pilvipalveluntarjoajat kehittävät uusia hinnoittelumalleja, erikoissopimuksia ja varmuusratkaisuja, jotka ottavat huomioon inferenssin jatkuvan luonteen. Esimerkiksi reservoitujen kapasiteettien, käynnissäolon priorisoinnin ja energiatehokkuuspohjaisten alennusten yhdistelmä voi muuttua tärkeäksi osaksi organisaatioiden valintakriteereitä.
Joten onko Nvidia tuomittu?
Ei lainkaan — mutta pelisäännöt muuttuvat. Nvidia johtaa yhä monipuolisessa GPU-laskennassa, sillä sen ohjelmistoekosysteemi, laaja markkinahylly ja vakiintuneet työkalut tekevät siitä ensisijaisen valinnan koulutukseen ja moniin inference-tilanteisiin. Ironwood kuitenkin avaa uuden kilpailuakselin, joka keskittyy inference-talouteen: siihen, kuinka monta kyselyä voidaan palvella halvimmalla ja nopeimmalla tavalla.
Yrityksille, jotka pyörittävät massiivisia reaaliaikajärjestelmiä, Googlen TPU-strategia voi muodostua ratkaisevaksi tekijäksi. Kun latenssi ja kustannus per kysely vaikuttavat suoraan liiketoiminnan tulokseen, infrastruktuurin valinta ei perustu pelkästään bruttotehoon (flopseihin), vaan siihen, miten tehokkaasti ja johdonmukaisesti laskenta voidaan viedä lähelle kyselyiden syntypaikkaa ja miten verkkoarkkitehtuuri sekä muisti-integraatio tukevat jatkuvaa kuormitusta.
Lyhyesti sanottuna: tekoälykilpailu kehittyy kysymykseksi "kuka palvelee eniten kyselyjä, halvimmalla ja nopeimmalla tavalla" sen sijaan, että mitattaisiin vain kuka omistaa eniten FLOPSeja. Ironwoodin siirtyessä tuotantokäyttöön on odotettavissa, että pilvipalveluntarjoajat, hyperskalaajat ja yritykset arvioivat uudelleen, missä ja miten he suorittavat inference-kuormansa — ja tämä tekee Googlesta juuri nyt mielenkiintoisimman haastajan seurattavaksi.
Lisähuomioita teknisille päättäjille: migraatio paikallisista GPU-räkeistä TPU-pohjaiseen pilvi-inferenceen vaatii arviointia mallin yhteensopivuudesta (quantization, mixed precision), verkon topologiasta, datan liikkuvuudesta sekä kustannusmallin simuloinnista pitkäkestoisissa käyttötilanteissa. Ennakoiva suunnittelu, proof-of-concept -testaukset ja kustannusmallit ovat keskeisiä päätöksenteon työkaluja. Yritysten kannattaa myös huomioida, että vaikka TPU voi olla kustannustehokas laajassa skaalassa, siirtymä- ja kehityskustannukset voivat olla merkittäviä lyhyellä aikavälillä.
Lopuksi, markkinanäkökulmasta kilpailun kiristyminen hyödyttää loppukäyttäjiä: parempi suorituskyky, alhaisemmat kustannukset ja uudet palvelumallit ovat todennäköisiä seuraamuksia, kun sekä Google että Nvidia sekä muut toimijat pyrkivät erottumaan inferenssin taloudessa ja teknisessä kyvykkyydessä.

"Olen digitaalisen markkinoinnin asiantuntija ja intohimoinen data-analytiikan seuraaja. Kirjoitan Diginissä siitä, miten teknologia vaikuttaa liiketoimintaan ja yhteiskuntaan."
Keskustelu
Jätä kommentti
Kommentit
Ei vielä kommentteja. Ole ensimmäinen.