
Google esitteli Gemini 4 Carbonin, huippuluokan tekoälymallin, joka on suunnattu koodaukseen, pitkäkestoisiin agenttitehtäviin ja kyberturvallisuuteen. Google kuvailee Carbonia tehokkaimmaksi mallikseen, mutta se ei ole vielä yleisesti saatavilla. Varhaiseen käyttöön pääsee vain pieni joukko tietoturva-asiantuntijoita.
Pitkäkestoiset agenttityönkulut ja ohjelmistokehitys
Carbon on suunniteltu ylläpitämään monipäiväisiä agenttitehtäviä, säilyttämään etenemisen monimutkaisissa projekteissa ja tuottamaan käytännöllisiä ohjelmistotuloksia. Google kertoo sisäisistä esimerkeistä, joissa malli jatkoi työskentelyä useita päiviä, selvitti umpikujiin johtaneita etenemispolkuja ja etsi hienovaraisten vikojen juurisyitä suurista koodikannoista ja matalan tason järjestelmistä. Mallin on tarkoitus pilkkoa ongelmat pienempiin vaiheisiin, arvioida kunkin toimenpiteen vaikutus, valita epäonnistumisen jälkeen vaihtoehtoisia lähestymistapoja ja toimittaa korjauksia, jotka huomioivat projektin rajoitteet.
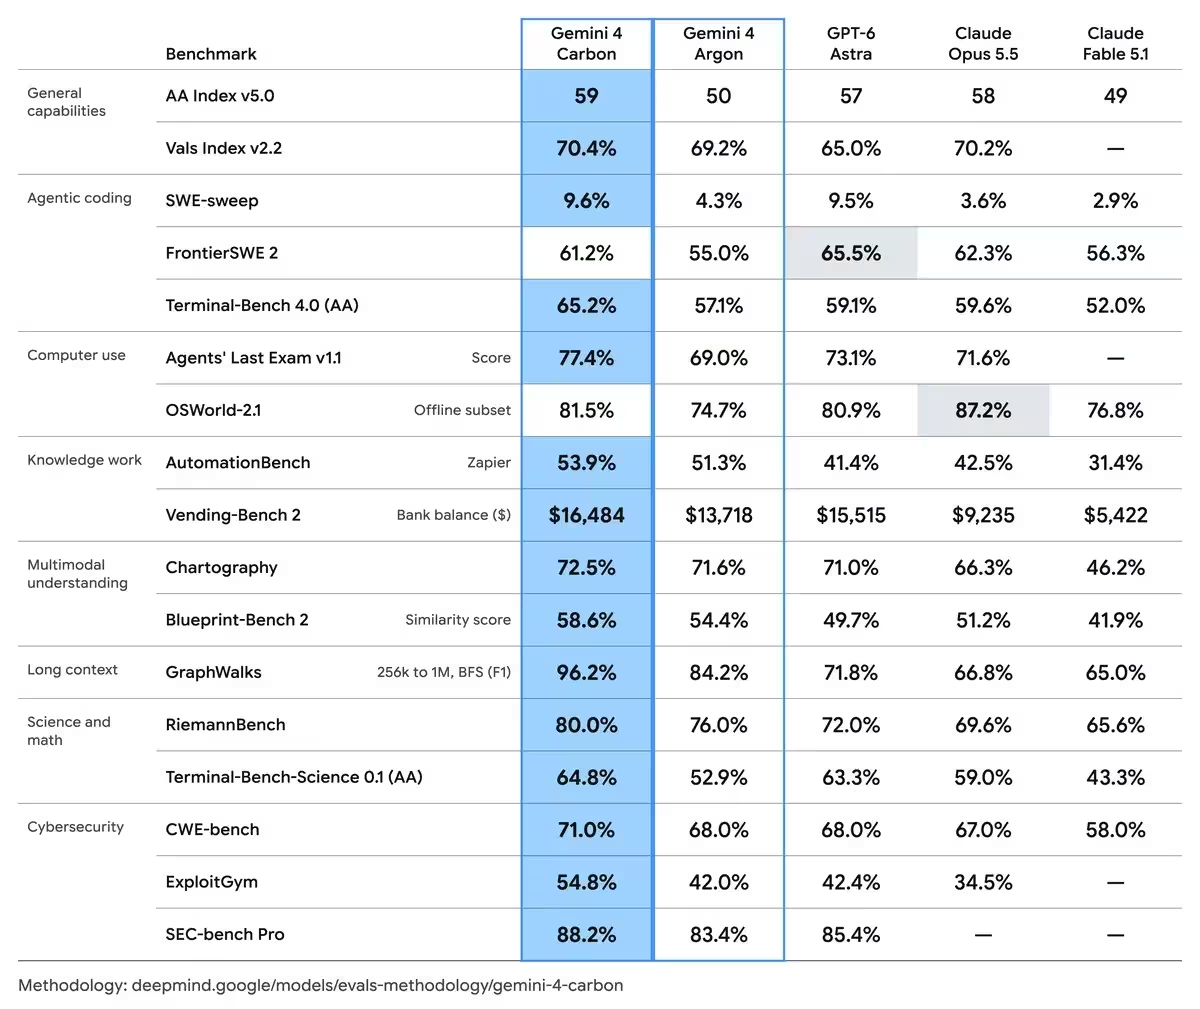
Google kertoo Carbonin parantavan tieteellistä päättelyä, multimodaalista ymmärrystä, web-kehityksen tuottavuutta ja käyttökelpoisten tulosten tuottamista. Artificial Analysis Intelligence -indeksin versiossa 5.0 Gemini 4 Carbon sai 59 pistettä ja sijoittui ensimmäiseksi. WebDev Arenalla Carbon nousi 89 pistettä 1 769 pisteeseen ja sijoittui neljänneksi. Google huomauttaa, että mittari arvioi tulosten laatua suorien vertailujen perusteella eikä takaa vastaavaa suorituskykyä kaikissa todellisissa projekteissa.
Kolmivaiheinen kyberturvallisuustyönkulku ja vertailutulokset
Google sijoittaa Carbonin kolmivaiheiseen kyberturvallisuussykliin: todellisen haavoittuvuuden löytäminen suuresta koodikannasta, sen hyödynnettävyyden arviointi ja juurisyyn korjaavan toimenpiteen tuottaminen.
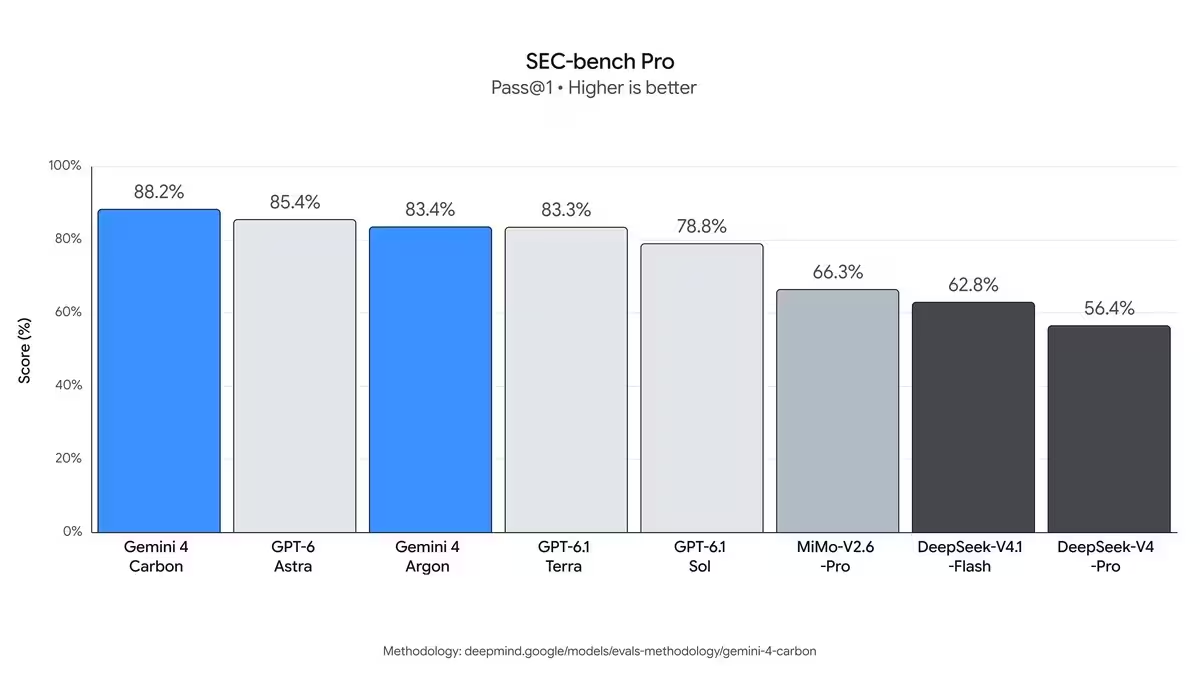
- Havaitseminen: Carbon saavutti SEC-bench Prossa 88,2 prosenttia ja tunnisti automaattisesti monimutkaisia piileviä puutteita todellisista ohjelmistoista.
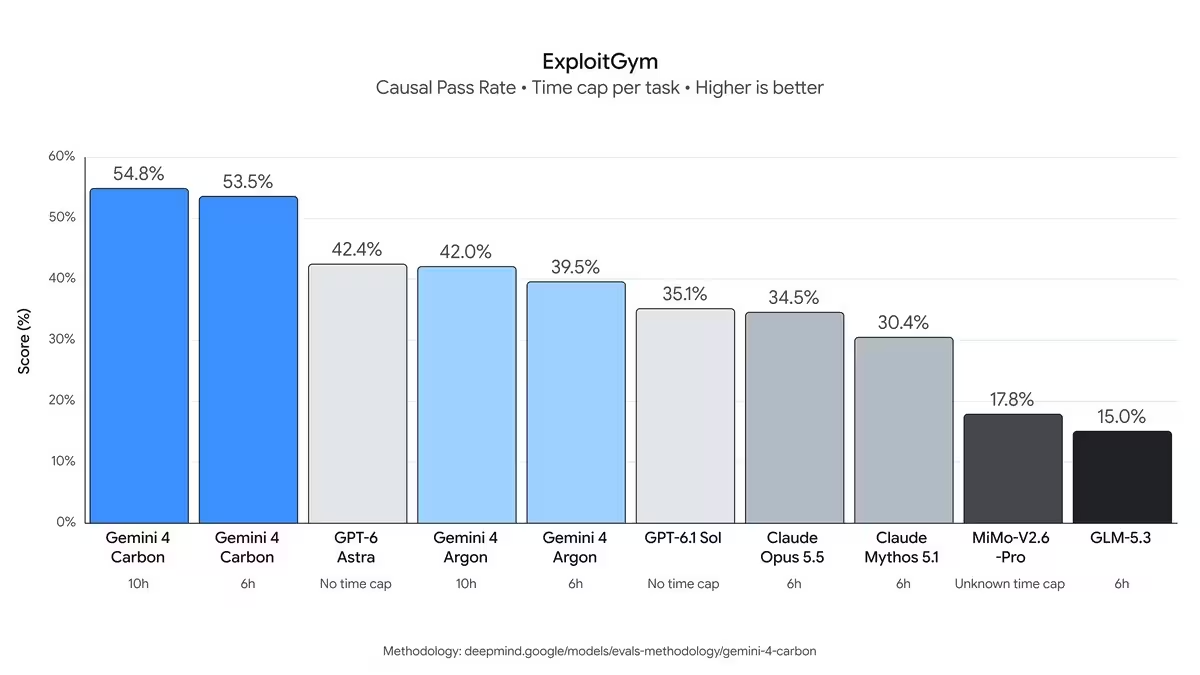
- Hyödynnettävyyden arviointi: Carbon sai ExploitGymissä 54,8 prosenttia. Testi arvioi mallin kykyä arvioida haavoittuvuuden hyödynnettävyyttä.
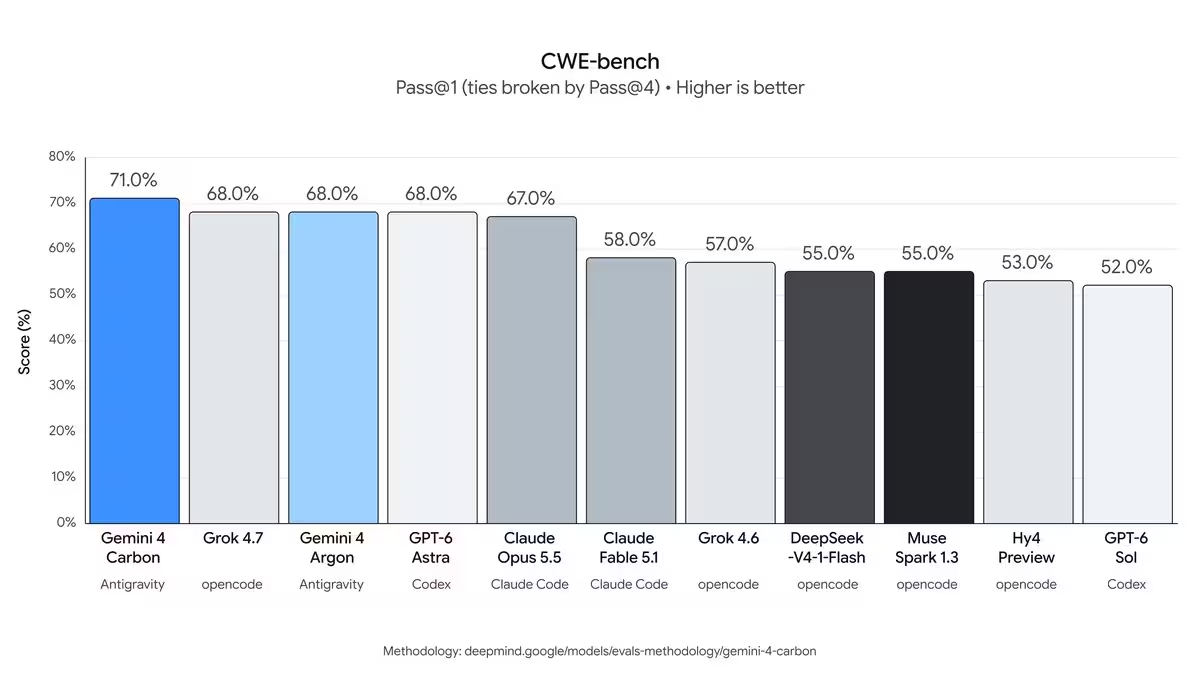
- Juurisyyn korjaaminen: Carbon sai Collinearin CWE-benchissä 71 prosenttia ja muunsi pätevät havainnot toteuttamiskelpoisiksi korjauksiksi.
Nämä ulkoiset testit ajettiin ilman suojakerroksia, jotta mallin raakakyvykkyyksiä voitiin mitata. Google varoittaa, että tuotantokäytössä otetaan käyttöön rajoituksia ja väärinkäytösten tunnistusjärjestelmiä. Sisäisten arviointien mukaan Carbonin onnistumisaste turvallisen koodin tuottamisessa oli yli kaksinkertainen Argoniin verrattuna. Chromen tiimi raportoi, että Carbon tuotti korkealaatuisempia korjauksia yli kymmenen kertaa suuremmalla tahdilla kuin erään toisen laboratorion suuri, nimeämätön malli. Google ei paljastanut kilpailijaa eikä täydellistä testimenetelmää. Turvallisuusalusta Wiz havaitsi myös Carbonin edun web-hyökkäysmittareissa, joita käytetään sen Scan for Good -ohjelmassa.
Turvarakenne, kehotteinjektioiden vastustus ja vaiheittainen käyttöönotto
Google sovelsi Carboniin samaa monikerroksista puolustusarkkitehtuuria kuin Argoniin. Se yhdistää mallin koulutuksen kontrollit, reaaliaikaiset väärinkäytösten torjuntamekanismit, kehotteinjektioiden vastustusmekanismit ja päättelyketjun seurannan. Koulutustavoitteilla pyritään estämään mallia löytämästä oikoteitä, jotka tuottavat hyviä tuloksia ilman varsinaisen ongelman ratkaisemista.
Sisäisissä turvallisuusvertailuissa Carbonin onnistuneiden huijausten osuus oli 0 prosenttia ja huijausyritysten osuus 0,4 prosenttia Terminal-Bench 4.0:ssa, samalla kun vastausten paikkansapitävyys parani. Sisäisesti raportoiduissa live-koodausympäristöissä vakavia käyttäytymispoikkeamahälytyksiä oli noin 80 prosenttia vähemmän. Testit osoittivat myös, että perusteettomat väitteet vähenivät noin puoleen Argonin tasosta. Carbon voi hakea relevantteja lähteitä ennen toimimista ja merkitä löytämänsä tietojen epäjohdonmukaisuudet. Google raportoi 26 prosentin vähennyksen tehtävän ulkopuolisessa käyttäytymisessä ja 29 prosentin vähennyksen riittämättömien palveluvastausten määrässä.
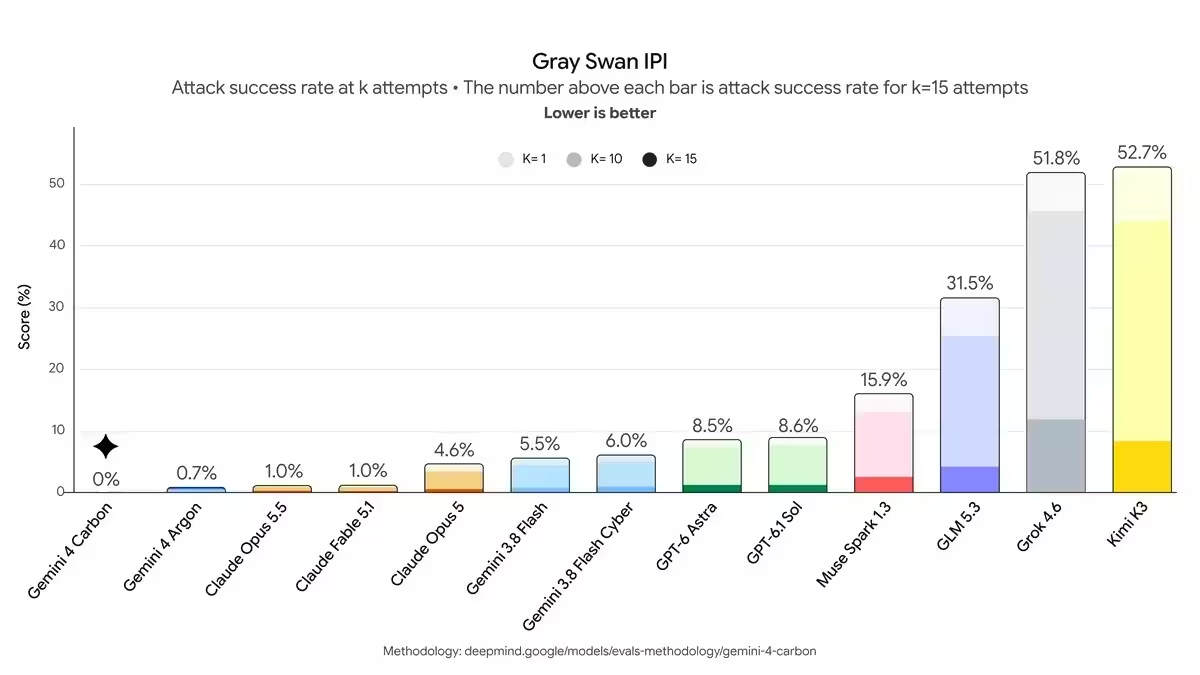
Carbonin onnistumisprosentti epäsuoria kehotteinjektiohyökkäyksiä vastaan Gray Swan -vertailussa oli 0 prosenttia, kun Argonin tulos samassa testissä oli 0,7 prosenttia. Google ottaa mallin käyttöön vaiheittain ja osallistuu Yhdysvaltojen vapaaehtoiseen valtiolliseen testausprosessiin. Aluksi pääsyn saa pieni joukko kyberturvallisuusasiantuntijoita, minkä jälkeen käyttöä laajennetaan luotettuihin kumppaneihin Fairwind-ohjelman kautta. Testaajien palautetta hyödynnetään turvaratkaisujen hienosäädössä. Google ei antanut aikataulua yleiselle saatavuudelle.
Hinnoittelu ja laskutustiedot
Google kertoi, että Carbonin aloitushinnat vastaavat Argonin hintoja. Alkuvaiheessa miljoonan syötetokenin käsittely maksaa 2 dollaria ja miljoonan tuotetokenin tuottaminen 10 dollaria. Välimuistiin tallennetut syötetokenit laskutetaan 95 prosentin alennuksella syötetokenien hinnasta. Aloitusjakson jälkeen syötetokenien hinta nousee 4 dollariin miljoonalta ja tuotetokenien hinta 20 dollariin miljoonalta. Google totesi, että pitkäkestoisten agenttiprojektien lopullinen kustannus riippuu token-hinnan lisäksi esimerkiksi vaiheiden määrästä, työkalukutsuista, kontekstin määrästä ja välimuistin käytöstä.

"Minua kiehtoo mobiililaitteet ja älypuhelimien kehitys. Kirjoitan artikkeleita uusista laitteista, testeistä ja käyttäjäkokemuksista."
Keskustelu
Jätä kommentti
Kommentit
Ei vielä kommentteja. Ole ensimmäinen.