

Tiivistelmä
Pyyhe, joka oli taiteltu kuin tarkka ihminen olisi sen käsitellyt. Palikat purettu vakailla käsillä. Pieniltä tuntuvia suorituksia, mutta silti paljastavia. Xiaomin uusi Robotics-0-malli ei ole silmiinpistävä kuluttajalaite; se on yritys opettaa koneita näkemään, ymmärtämään ja liikkumaan sillä hienovaraisuudella, jonka olemme pitkään laskeneet inhimillisen intuitiivisuuden varaan.
Arkkitehtuuri: erottelu näkemisen ja liikkeen välillä
Robotics-0 pyrkii sydämessään sulkemaan ympyrän, joka määrittää minkä tahansa kykenevän robotin: havaitseminen, päätöksenteko ja toimeenpano. Yritys tiivistää tämän käsitteen termiksi ”fyysinen älykkyys” — lyhyt ilmaus, joka kätkee alleen joukon vaikeita teknisiä ja käytännöllisiä haasteita. Kuinka ylläpidetään järjestelmän terävyyttä kielen ja kuvan päättelyssä samalla kun opetetaan tekemään millimetrintarkkoja liikkeitä? Xiaomin vastaus on arkkitehtuuri, joka erottaa ajattelun ja liikkeen kahteen koordinoituun osaan.
Visuaalinen kielimalli: robotin tulkki
Toisella puolella toimii Visual Language Model — ajattele sitä robotin tulkkina. Malli sulattaa korkearesoluutioiset kamerasyötteet ja ihmisen antamat ohjeet, myös epämääräisemmät, kuten ”Voisitko taitella pyyhkeen?”. Se hoitaa esineentunnistuksen, spatiaalisten suhteiden ymmärtämisen, visuaalisen kysymys-vastaus -toiminnallisuuden (visual Q&A) ja sellaisen arkijärkisen päättelyn, joka muuttaa pikselit tehtäviksi. Käytännössä tämä osa vastaa siitä, että robotti ymmärtää mitä ympäristössä tapahtuu ja mitä tavoitteita sille asetetaan.
Action Expert: liikkeen erikoistunut osa
Toisena puolena on Action Expert: Diffusion Transformer, joka ei suoltaa ulos yhtä yksittäistä moottorikäskyä, vaan tuottaa niin kutsutun ”toimintokappaleen” (Action Chunk) — lyhyen, koordinoitujen liikkeiden sarjan. Tämä lähestymistapa johtaa käytännössä sulavampiin siirtymiin ja vähemmän nykivään korjailuun, sillä liikkeet suunnitellaan lyhyiksi aikajaksoiksi ja niihin sisältyy kontekstuaalista koordinaatiota molempien käsien ja näkökentän välillä.
Mixture-of-Transformers -ajatus ja multimodaalinen yhteisopetus
Käytännön insinöörivalinta tämän kahtiajaon taustalla on nimeltään Mixture-of-Transformers-arkkitehtuuri. Vastuut jaetaan sen sijaan, että ne pakotettaisiin yhteen monoliittiseen malliin. Tämä ratkaisu auttaa ratkomaan tunnetun ongelman: kun opetat visio-kielimallia toimimaan, se usein menettää osan päättelykyvystään. Pitääkseen molemmat taidot – näkemisen ja päättelyn – terävinä, Xiaomi harjoittaa yhteisopetusta multimodaalisella datalla ja todellisilla toimintatrajektorioilla, jolloin malli säilyttää älyllisen kapasiteetin samalla, kun se oppii liikkeen hienouksia.

Koulutusputki: vaiheittainen oppiminen
Koulutus tapahtuu vaiheittain. Ensimmäinen vaihe on Action Proposal, jossa visuaalinen malli ennustaa todennäköisyysjakaumia mahdollisista toiminnoista kuvan lukemisen perusteella. Tämä vaihe synkronoi näkemisen ja tekemisen sisäisiä esityksiä, eli se muodostaa yhtenäisen ymmärryksen siitä, mitkä toimet ovat tilanteessa järkeviä. Tämän jälkeen visuaalinen osio ”jäädytetään” — sen painot lukitaan, jotta sen päättelykyky ei muutu liikaa seuraavissa vaiheissa.
Diffuusio-transformerin rooli
Tämän jälkeen Diffusion Transformer koulutetaan puhdistamaan eli denoiseroimaan toimintojaksoja — se muuttaa kohisevat, epävarmat arviot toteutettaviksi liikkeiksi. Tässä vaiheessa malli hyödyntää avain-arvo-ominaisuuksia (key-value features) perinteisten, diskreettien kielitunnisteiden sijaan. Tämä auttaa siirtämään kontekstuaalista visuaalista tietoa suoraan liike-ennusteeseen ilman, että välimuistiin syntyy merkittävää käännöshävikkiä tekstin ja liikkeen välillä.
Käytännön haasteet ja ratkaisut
Reaalimaailman robotit paljastavat aina lisää kitkaa kuin simulaatiot antavat ymmärtää. Yksi konkreettinen ongelma on latenssi. Kun malli pysähtyy miettimään, robotti usein jähmettyy tai horjahtaa. Xiaomi käsittelee tätä asynkronisella inferenssillä: laskenta ja laitteisto toimivat osittain itsenäisesti, jolloin liike pysyy jatkuvana, vaikka malli vielä laskisikin seuraavaa päätöstä. Tämä on tärkeää erityisesti pitkäkestoisissa tehtävissä, joissa jatkuvuus ja momentum vaikuttavat tehtävän onnistumiseen.
Clean Action Prefix ja lambda-huomiomaski
He palauttavat myös aikaisemmin ennustettuja toimintoja takaisinkytkentänä järjestelmään — menetelmää kutsutaan nimellä ”Clean Action Prefix” — mikä auttaa vaimentamaan tärinää ja ylläpitämään liikemomenttia. Lisäksi huomion (attention) maski, joka on muodoltaan lambda (Λ), painottaa järjestelmän huomion nykyisten visuaalisten vihjeiden suuntaan vanhan historian sijaan. Tämä parantaa herkkyyttä äkillisiin muutoksiin ympäristössä ja vähentää tilanteita, joissa vanhentunut konteksti johtaa sopimattomiin toimiin.
Mittarit, simulaatiot ja kenttätestit
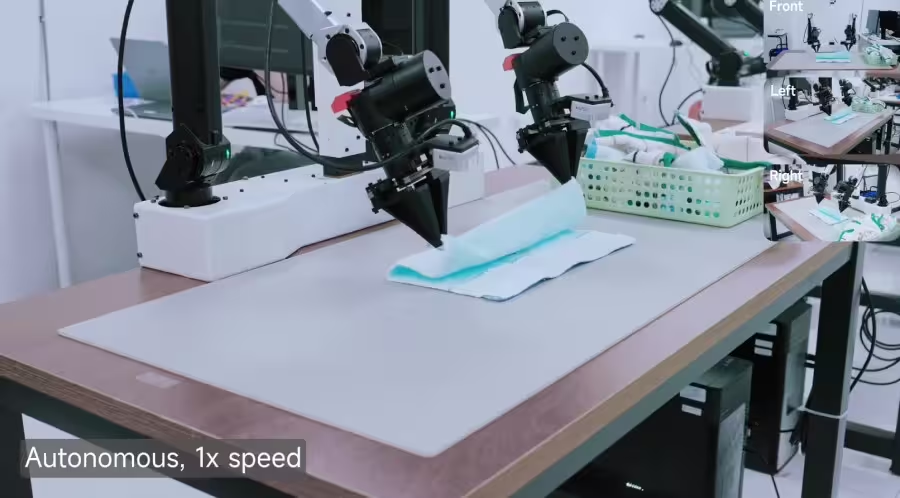
Mittarit kertovat osan tarinaa. Xiaomi raportoi huipputuloksia useissa tunnetuissa simulaatioympäristöissä kuten LIBERO, CALVIN ja SimplerEnv, ohittaen noin 30 vertaisjärjestelmää. Numerot ovat tärkeitä, mutta oikeiden laitteiden kenttätestit ovat enintään yhtä ratkaisevia. Kaksikätisellä alustalla Robotics-0 selvisi pitkän aikavälin tehtävistä, kuten pyyhkeen taittelusta ja palikkarakenteiden purkamisesta, osoittaen vakaata käsi-silmä-koordinaatiota ja kykyä käsitellä sekä jäykkiä että joustavia esineitä ilman ilmeisiä kriittisiä virhetapoja.
Mittarien ja käytännön testien yhteys
Simulaatio- ja reaalimaailmat poikkeavat usein siinä, miten sensorivirheet, kitkat ja epäsäännöllisyydet vaikuttavat suoritukseen. Siksi Xiaomin raportit sisältävät sekä simulointituloksia että demoja oikeilla laitteilla: suorituskyvyn yhteneväisyys näissä kahdessa kontekstissa on merkki arkkitehtuurin kestävyydestä. Lisäksi pitkäkestoiset tehtävät paljastavat järjestelmän kyvyn ylläpitää tilamallia ja reagoida dynaamisiin muutoksiin, mikä on olennaista kotitalous- ja teollisuusrobotiikassa.
Avoin lähdekoodi ja tutkimusyhteisölle merkitys
Toinen käytännön seikka on se, että Xiaomi julkaisee Robotics-0:n avoimen lähdekoodin projektina. Tämä on merkittävää tutkimuksen nopeudelle ja luotettavuudelle: kun tiimit voivat tarkastella koodia, toistaa kokeita ja rakentaa toistensa töiden päälle, kehitys kiihtyy. Odotettavissa on jatkotutkimuksia, haarukoita (forks) ja nopeita iteraatioita, joissa samat VLA (vision-language-action) -ajatukset sovelletaan erilaisiin laitteistoihin ja käyttötapauksiin.
Yhteisölliset edut ja standardointi
Avoimuus auttaa myös standardoitujen benchmarkien kehityksessä ja vertailukelpoisuuden parantamisessa. Kun lähdekoodi ja datat ovat julkisia, tutkimusyhteisö voi paljastaa piileviä heikkouksia, parantaa turvallisuusominaisuuksia ja löytää tehokkaampia tapoja integroida visuaalista päättelyä liikkeen generaation kanssa. Tämä on olennaista, jos tavoitteena on laajempi kaupallinen käyttöönotto ja luotettavuus kotitalousympäristöissä.
Rajoitteet ja avoimet haasteet
Robotics-0 ei ratkaise kaikkia ongelmia. Pehmeiden esineiden käsittely, yleistyminen hyvin erilaisiin ympäristöihin ja täysi autonomia jäävät avoimiksi haasteiksi. Pehmeiden materiaalien, kuten vaatteiden ja pyyhkeiden, manipulointi on esimerkkinä vaativa tehtävä: se vaatii tarkkaa kontaktinhallintaa, tuntoaistimusta ja pitkäkestoista tilamallin ylläpitoa. Lisäksi siirryttäessä täysin uusille ympäristötyypeille tai huonekalukonfiguraatioille vaaditaan laajempaa datan monimuotoisuutta ja parempaa domain-yleistämistä.
Skalautuvuus ja turvallisuus
Toinen rajoite liittyy skaalautuvuuteen ja turvallisuusvaatimuksiin. Kaksikäinen robottialusta on yksi asia laboratorio-olosuhteissa, mutta integroidessa robottia tehtäviin, joissa ihmiset ovat läsnä, vaaditaan lisätasoja hyväksyttävyyttä, ennakoitavuutta ja virheensietoa. Arkkitehtuuriset valinnat, kuten erottelu näkemisen ja liikkeen välillä, auttavat tässä, mutta ne eivät poista tarvetta laajalle turvatestaukselle ja käytännön standardeille.
Tekniset oivallukset ja erot kilpailijoihin nähden
Mitkä seikat tekevät Robotics-0:sta kiinnostavan verrattuna yleisiin robotiikan ja tekoälyn lähestymistapoihin? Ensinnäkin selkeä roolijako: visuaalinen malli säilyttää päättelykykynsä sen sijaan, että se uhrattaisiin liikkeen hyväksi. Toiseksi Diffusion Transformer -periaatteella tuotetut Action Chunk -ketjut mahdollistavat liikkeiden suunnittelun ajassa ja vähentävät reaktiivista nykimistä. Kolmanneksi asynkroninen inferenssi ja Clean Action Prefix -mekanismi vastaavat konkreettisiin käyttötilanteiden haasteisiin, kuten latenssiin ja jatkuvuuden ylläpitämiseen.
Arkkitehtuurin pragmaattinen etu
Tämä on muistutus siitä, että edistys voi syntyä arkkitehtuurivalinnoista yhtä paljon kuin suurempien mallien kouluttamisesta. Mallin jakaminen erillisiin, mutta koordinoituihin osiin antaa paremman hallinnan oppimisprosessiin ja helpottaa vianetsintää, päivityksiä sekä laitteistoriippumattomuutta. Samalla se tukee tutkimuksellista läpinäkyvyyttä: tutkijat voivat kehittää esimerkiksi paremman visuaalisen päättelyn tai tehokkaamman diffuusio-mallin erillisinä moduuleina.
Lopuksi: mitä seuraavaksi?
Jos seur saat, missä suuntaan robotit liikkuvat seuraavaksi, seuraa tarkasti kuinka tämä malli käyttäytyy Xiaomin laboratorioiden ulkopuolella ja mitkä osat yhteisö päättää säilyttää ja jalostaa. Seuraavan kerran, kun kotirobotti taittelee pyyhkeen sujuvasti, saatat nähdä Robotics-0:n jäljet jokaisessa tasaisessa taitteessa. Malli ei ole kaikkivoipa, mutta se tarjoaa käytännöllisen suunnan: pitää havainto ja toiminta tiiviisti linjassa ilman, että toinen syö toisen kyvykkyyden — ja muistuttaa, että arkkitehtuurilla on merkitystä.

"Työskentelen pilvipalveluiden parissa ja kirjoitan Diginissä niiden hyödyistä yrityksille ja yksityisille käyttäjille. Haluan tehdä monimutkaisesta teknologiasta helposti ymmärrettävää."
Keskustelu
Jätä kommentti
Kommentit
Ei vielä kommentteja. Ole ensimmäinen.