
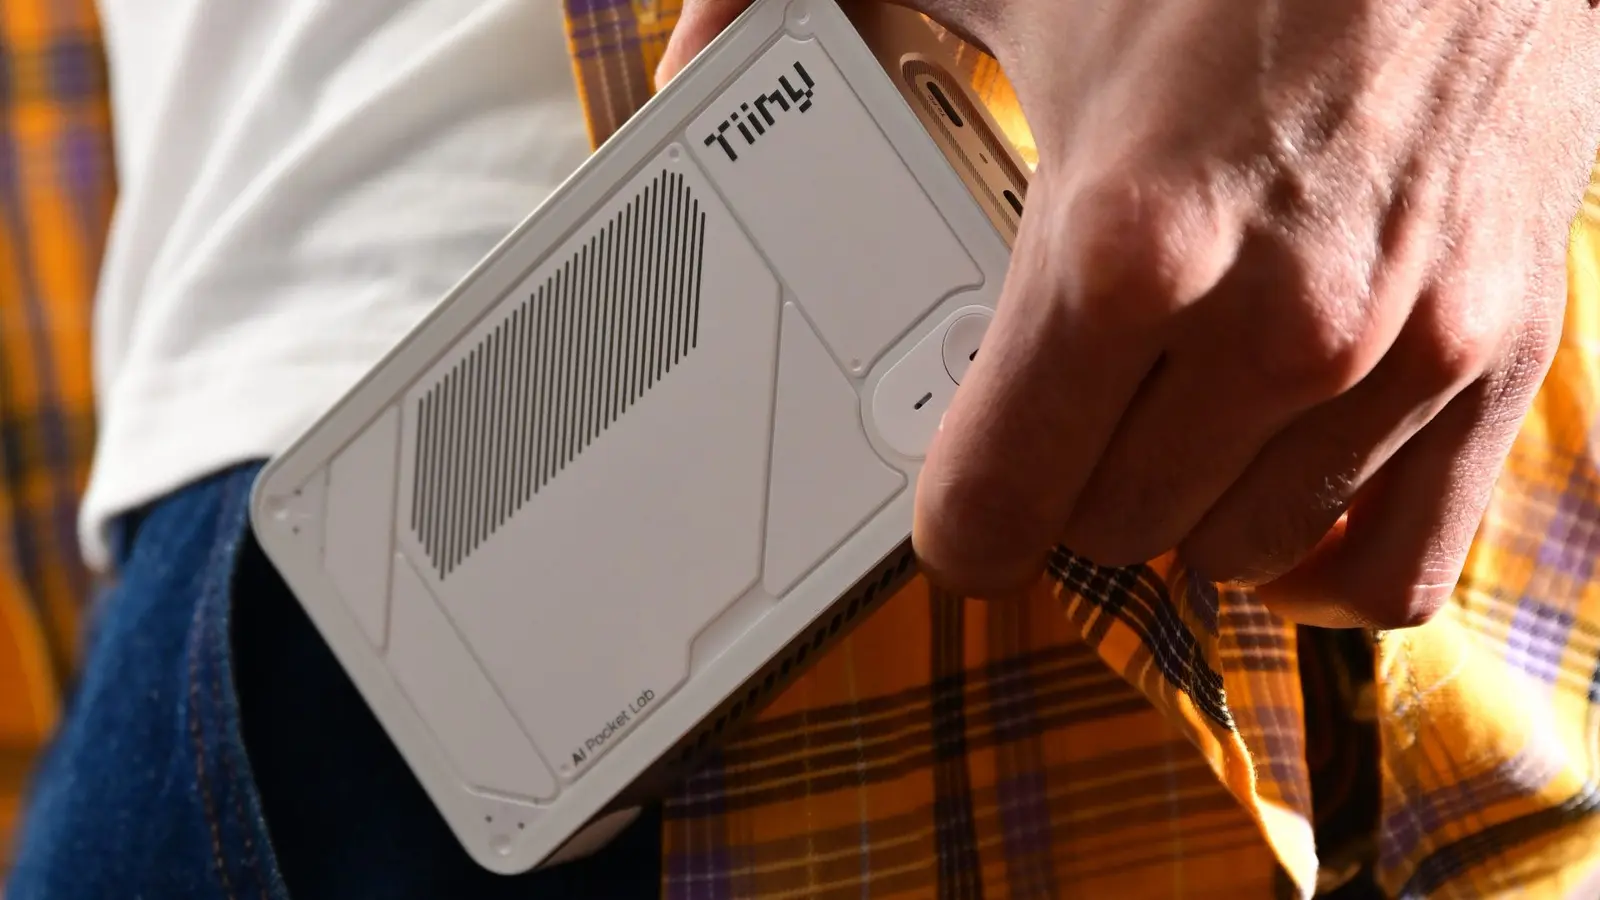
Tiiny AI veikkaa, että seuraava askel tekoälylaitteistossa ei ole datakeskuksen kaapissa — se mahtuu käteen. Startup paljasti Pocket Lab -nimisen laitteensa, kämmenen kokoisen ”supertietokoneen”, joka on suunniteltu ajamaan 120 miljardin parametrin suuruisia kielimalleja (LLM) täysin offline-tilassa.
Pieni laite, suuret lupaukset
Älä anna mittojen pettää silmääsi. Kooltaan noin 14.2 × 8 × 2.53 cm ja painoltaan noin 300 grammaa Pocket Lab on aidosti kannettava laite. Tiiny AI kuitenkin väittää, että laite pystyy isännöimään raskaita avoimia malleja, jotka perinteisesti vaativat kalliita GPU-klustereita. Lupauksena on tohtoritason päättelyä, monivaiheista analyysiä ja syvällistä kontekstin ymmärrystä ilman pilveä.
Tämänkaltaiset väitteet haastavat nykyiset oletukset reunalaskennasta (edge computing) ja offline-LLM-sovelluksista. Pocket Labin konsepti puhuu suoraan kehittäjille, tutkijoille ja tietoturva-ammattilaisille, jotka arvostavat omaa laskentatehoa, matalaa latenssia ja yksityisyyttä ilman jatkuvia pilvikuluja tai verkko-riippuvuutta.
Tekniset ominaisuudet, jotka selittävät hypen
Paperilla Pocket Lab näyttää tiivistetyltä palvelimelta. Keskeiset kohokohdat sisältävät:
- ARMv9.2 -pohjainen 12-ytiminen suoritin yleislaskentaa varten
- Räätälöity heterogeeninen laskentamoduuli (SoC + erillinen NPU), joka tuottaa noin 190 TOPS
- 80 GB LPDDR5X -muistia ja 1 TB SSD suurempien mallien paikalliseen majoitukseen ja nopeaan I/O:hon
- Mahdollisuus ajaa jopa 120 miljardin parametrin LLM-malleja kokonaan laitteella aggressiivisen kvantisoinnin avulla
- Tehoprofiili, joka on suunnattu noin ~30W TDP:hen ja ~65W tyypilliseen järjestelmätehoon — selvästi pienempi kuin vastaavien palvelinratkaisujen kulutus
- Offline-ensisijainen käyttö sekä yhdellä napsautuksella tapahtuva käyttöönotto useille avoimen lähdekoodin LLM-malleille ja agenttikehyksille
Nämä tekniset valinnat — suuri määrä nopeaa muistia, korkean TOPS-arvon NPU ja SSD-tallennustila — muodostavat yhdessä perustan sille, että suuret mallit voivat asua ja toimia paikallisesti. Muistin ja I/O:n mitoitus pyrkii minimoimaan mallin latausajat ja mahdollistaa pidemmät kontekstit ilman jatkuvaa disk-välitystä.

Kuinka se ajaa 120B-mallin taskussa?
Salaisuus on laitteistotiheyden ja ohjelmiston optimointien yhdistelmä. Pocket Lab sisältää erillisen NPU:n, joka tarjoaa korkean TOPS-suorituskyvyn, mutta Tiiny AI luottaa myös kahteen keskeiseen tekniikkaan, jotta suuret mallit pysyvät käytännöllisinä rajallisella piipinta-alalla:
- TurboSparse — neuronitasoinen harvan aktivoinnin lähestymistapa, joka puristaa inferenssitehokkuutta alentamatta mallin päättelykykyä. Tuloksena on vähemmän laskutoimituksia mutta säilynyt älykkyys.
- PowerInfer — avoimen lähdekoodin heterogeeninen inferenssimoottori (suosittu GitHubissa), joka jakaa kuormituksia dynaamisesti CPU:n ja NPU:n välillä. Se orkestroi laskennan niin, että saavutetaan palvelintason läpäisy pienemmällä energiankulutuksella.
Yhdistettynä 80 GB LPDDR5X-muistiin, joka mahdollistaa aggressiivisen kvantisoinnin ja muistitehokkaan suorituksen, nämä tekniikat tekevät 120B-mallien paikallisesta ajamisesta käytännöllisen toteutuksen eikä vain teoreettisen mahdollisuuden. Käytännössä tämä tarkoittaa myös useita rinnakkaisia optimointikerroksia: operaatioiden yhdistämistä (operator fusion), matriisikomponenttien pakkausta, älykästä muistin jakamista ja vaiheittaista latausta (memory swapping) niin, että koko malli ei aina tarvitse olla dekoodattuna täyteen muistiin.
TurboSparse: harvinainen aktivaation hallinta
TurboSparse vähentää laskutoimituksia tunnistamalla toistuvia ja vähämerkityksisiä neuronien aktivaatioita mallin sisällä ja asettamalla ne vähemmän laskentaintensiiviseen polkuun. Teknisesti tämä voi hyödyntää matriisien harvoittamista sekä dynaamista prunausta (dynamic pruning), jolloin vain olennaiset matriisiosat lasketaan täsmällisesti. Tällainen lähestymistapa edellyttää myös tarkkaa kalibrointia, jotta kvantisointi- ja harvennusvaiheet eivät heikennä lopullista tulkintaa tai kontekstin hallintaa.
PowerInfer: orkestrointi CPU:n ja NPU:n välillä
PowerInfer toimii kuten ohjauskeskus, joka jakaa laskennalliset työvaiheet tehokkaimmin käytettävissä oleville yksiköille. Monille LLM-operaatioille NPU tarjoaa parhaan suorituksen, kun taas tietyt kontrollilogikat, muistohallinta ja pienemmät datasiirrot hoidetaan CPU:lla. Dynaaminen kuormanjako vähentää muistensiirtoihin liittyvää overheadia ja parantaa kokonaisenergiatehokkuutta. Lisäksi PowerInfer tukee useita matemaattisia backendeja ja operaatio-optiota, mikä lisää yhteensopivuutta erilaisten mallirakenteiden kanssa.
Kaikki nämä ohjelmisto- ja laitteisto-optimoinnit ovat keskeisiä, kun pyritään siirtämään palvelinluokan kielimallit reunalaitteeseen. Ne muodostavat kerroksittain toimivan järjestelmän: laitteistotason topologia, mikrokoodin optimoinnit, inferenssimoottorin orkestrointi ja mallikohtaiset kvantisointistrategiat.
Mallit, yksityisyys ja käytännön sovellukset
Pocket Lab tukee laajaa avoimien mallien katalogia — GPT-OSS:stä ja Llamasta Qweniin, Mistraliin ja Phiin — jolloin kehittäjät voivat valita arkkitehtuurin tarpeisiinsa. Koska laite toimii täysin offline-tilassa, se on houkutteleva vaihtoehto yksityisyyteen painottaville käyttöönotolle, kenttätutkimukselle ja kehittäjille, jotka haluavat nopean iteroinnin ilman pilven latenssia tai jatkuvia kustannuksia.
Tällaisen offline-kyvyn etuja ovat muun muassa:
- Henkilötietojen ja arkaluonteisen datan pysyminen paikallisesti, mikä vähentää tietovuotojen riskiä ja helpottaa tietosuojavaatimusten täyttämistä.
- Low-latency-sovellukset, joissa reaaliaikainen vastaus on kriittinen ilman verkon tuomaa viivettä.
- Toiminta paikoissa, joissa verkkoyhteys on epäluotettava tai ei-toivottu: tutkimusasemilla, kenttätestauksissa, sotilaallisissa tai teollisissa ympäristöissä.
Käyttötapaukset ja esimerkit
Ajattele tilannetta, jossa tutkija testaa uutta agenttiprosessia työpöydällään tai insinööri suorittaa monimutkaista luonnollisen kielen prosessointia (NLP) hajautetussa kenttäympäristössä. Pocket Lab voi mahdollistaa useita konkreettisia käyttötapauksia:
- Terveysalalla: luonnollisen kielen analyysi offline-potilastiedoille, diagnosoinnin apukurssit ilman potilastietojen siirtoa pilveen.
- Teollisuusautomaation reunalla: monimutkainen tilanneanalyysi, huoltoagentit ja vikasietoisuus ilman keskitettyä palvelinta.
- Tutkimus ja kenttätyö: luonnonvarojen arviointi tai kielitieteelliset tutkimukset etäalueilla, joissa yhteydet ovat rajalliset.
- Yrityksen sisäiset sovellukset: salaiset strategiat, IP-suojatut mallit ja sisäinen automaatio ilman kolmannen osapuolen pääsyä.
Tällaiset sovellukset vahvistavat Pocket Labin asemaa reunalaskennan (edge AI) laitteena, joka yhdistää suorituskyvyn, yksityisyyden ja kannettavuuden.
Mitä seuraavaksi: CES ja avoimet kysymykset
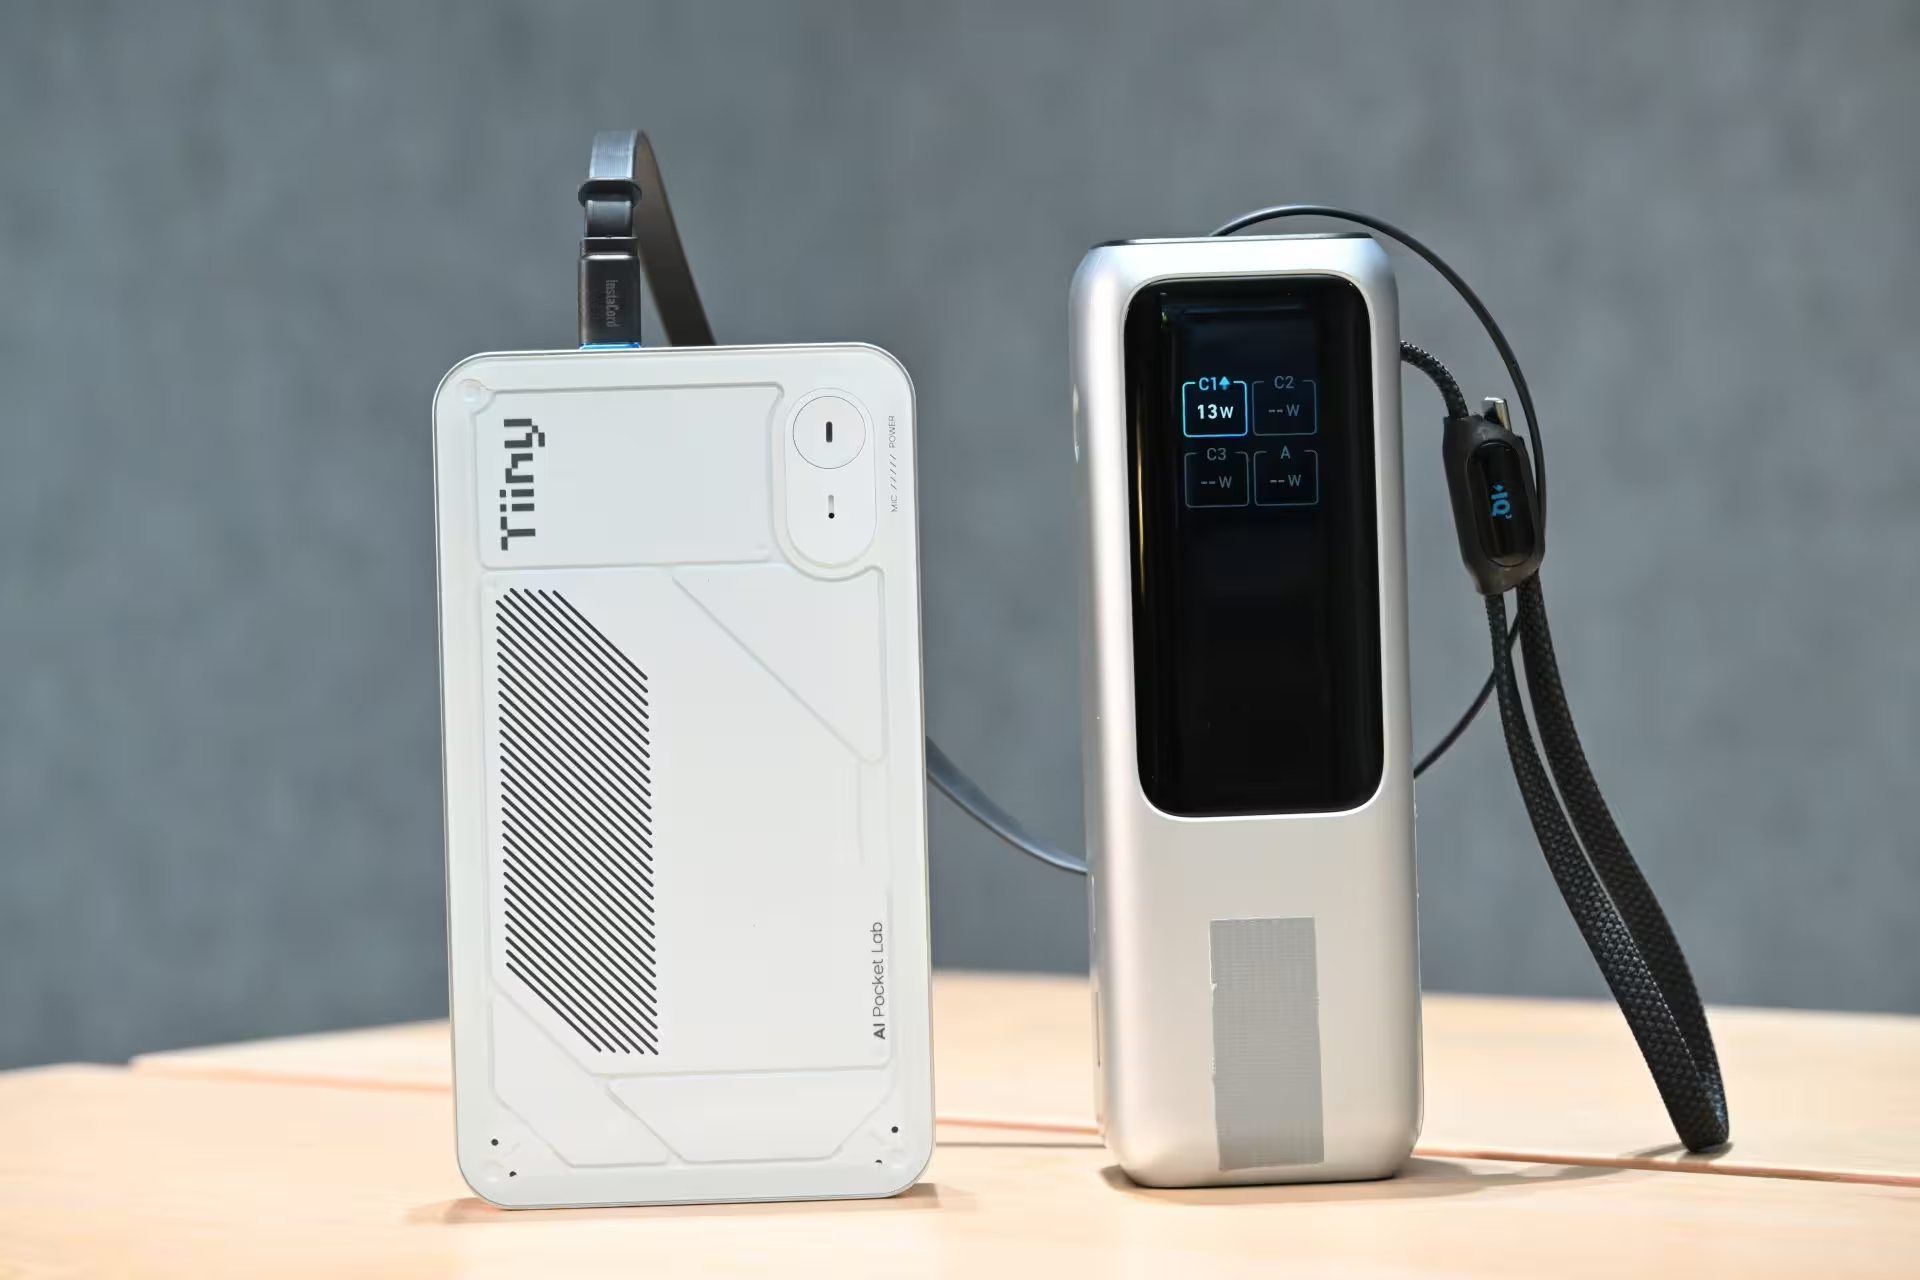
Tiiny AI aikoo esitellä Pocket Labin CES 2026 -tapahtumassa. Yritys ei ole vielä julkistanut hintaa tai toimitusaikataulua, ja todelliset suorituskykyvertailut (benchmarks) ovat ratkaisevassa roolissa: pystyykö taskukokoinen kone toistuvasti vastaamaan palvelinluokan kuormituksiin erilaisissa real-world -skenaarioissa?
Tähän liittyy useita testattavia osa-alueita:
- Suorituskyky eri mallikokoluokissa: miten Pocket Lab skaalautuu 20B-, 70B- ja 120B-malien välillä?
- Latenssi ja läpäisy: pystyykö laite ylläpitämään serveritason throughputia pitkissä inferenssityönkuormissa?
- Energiankulutus ja lämmönhallinta: miten lämpö- ja virransyöttörajoitukset vaikuttavat pitkäkestoisiin tehtäviin, erityisesti offline- ja kenttäkäytössä?
- Yhteensopivuus ja ekosysteemi: kuinka laaja valikoima avoimia malleja ja agenttikehyksiä on tuettu ja miten helppoa kehittäjän on ottaa laite tuotantokäyttöön?
Vaikka Pocket Lab herättää innostusta, sen julkaisu nostaa myös tärkeitä keskustelunaiheita. Avoimuus suorituskykytesteissä, käyttöehtojen ja mallilisenssien selkeys sekä päivitys- ja turvallisuusprosessit määrittävät pitkälti, miten nopeasti laite saa laajempaa hyväksyntää ammattilaisten keskuudessa.
Rajoitukset ja riskit
Kuten missä tahansa reunalaitteessa, Pocket Labin kaltaisessa tuotteessa on kompromisseja. Aggressiivinen kvantisointi ja harvennus voivat johtaa pieneen tarkkuuden heikkenemiseen tietyissä tehtävissä; hardware-arkkitehtuuri on optimoitu tiettyihin operaatiotyyppeihin; ja laitteiden päivittäminen, mallien parantaminen sekä turvallisuuskorjausten jakelu edellyttävät vakiintunutta ekosysteemiä. Lisäksi riippuvuus avoimen lähdekoodin ekosysteemeistä tuo mukanaan lisävastuita mallien validoinnissa ja lisenssiehtojen noudattamisessa.
Kilpailuasema ja erottuvuustekijät
Pocket Lab yrittää erottua kilpailijoista tarjoamalla yhdistelmän kannettavuutta, itsenäistä offline-laskentaa ja tukea suurille LLM-malleille. Verrattuna perinteisiin reunalaiteratkaisuihin, kuten pieneen GPU-moduuleihin tai Sulautettuihin AI-piireihin (esim. Jetson-tyyppiset laitteet), Pocket Lab pyrkii nostamaan suorituskyvyn tasolle, joka aiemmin oli yksinomaan datakeskuksissa. Erotusperusteena ovat myös PowerInfer- ja TurboSparse-optimoinnit sekä suuri LPDDR5X-muisti, jotka yhdessä mahdollistavat suurempien mallien paikallisen ajamisen.
Tämän lisäksi yrityksen menestys riippuu ekosysteemin tuesta: kuinka helppoa kehittäjien on siirtää olemassa olevia malleja Pocket Labille, miten laaja valikoima esiasennettuja avoimen lähdekoodin malleja on, ja kuinka hyvin laite integroidaan yleisiin kehitystyökaluihin ja CI/CD-putkiin.
Yhteenveto: merkki muutoksesta reunalaskennassa
Vaikka monet yksityiskohdat odottavat vielä vahvistusta, Pocket Lab osoittaa mielenkiintoisen suunnan reunalaskennassa ja offline-LLM-kehityksessä. Siirrymme yhä useammin tilanteeseen, jossa voimakas laskenta tapahtuu paikallisesti — ei vain pienissä sensoreissa, vaan myös kannettavissa, tietoturvallisissa laitteissa, jotka tukevat monimutkaisia kielimalleja.
Tämä voi muuttaa tapaa, jolla kehittäjät, tutkijat ja yksityisyyttä arvostavat käyttäjät toimivat LLM:ien kanssa: vähemmän pilveä, enemmän nopeutta ja suurempi kontrolli datasta. Lopullinen arvio riippuu kuitenkin Pocket Labin todellisista mittauksista kenttäolosuhteissa, hintarakenteesta ja siitä, kuinka laajasti sen ekosysteemi kehittyy tukemaan erilaisia sovelluksia ja malleja.
Seuraa CES 2026 -esitystä ja julkaistavia benchmarkeja, kun todellinen suorituskyky ja käytännön soveltuvuus tulevat selkeämmiksi. Reunalaskennan tulevaisuus näyttää ainakin mielenkiintoiselta — ja kompaktimmalta kuin koskaan.

"Olen tietoturva-asiantuntija ja seuraan kyberturvallisuuden trendejä. Diginissä jaan vinkkejä ja uutisia, joilla pysyt turvassa digitaalisessa maailmassa."
Keskustelu
Jätä kommentti
Kommentit
Ei vielä kommentteja. Ole ensimmäinen.