
Kuvittele meneväsi liveen ja huomaat, että ilman suurta ilmoitusta äänesi ja kuvasi päätyvät osaksi Amazonin seuraavan sukupolven tekoälyn koulutusdataa. Tätä Twitch juuri ilmoitti: lähetyssisältöä voidaan nyt käyttää Amazonin mallien kouluttamiseen, elleivät sisällöntuottajat erikseen poistu käytöstä.
Tietosuojakiistat raakakoulutusdatan käytöstä eivät ole enää pelkkää teoriaa. Kehittäjät ja lakitiimit ovat väännelleet vuosia suurten mallien oppimislähteistä. Jotkut yritykset väistävät kiistan käyttämällä vain omien alustojensa materiaalia. Esimerkiksi Meta voi hyödyntää Facebookin ja Instagramin julkisia sivuja. Yksityiset profiilit pysyvät kuitenkin periaatteessa poissa käytöstä.
Se, mikä erottaa Twitchin, on mittakaava ja läheisyys. Lähetykset ovat pitkiä, monimuotoisia ja kaoottisia: tunteja ääntä, kasvokameraa, reaaliaikaista keskustelua, pelikuvaa ja spontaania vuorovaikutusta, joita ei löydy kuratoiduista arkistoista. Tekoälytutkijoille tuo kaaos on aarreaitta mallien opettamiseen puhumaan, reagoimaan ja käyttäytymään luonnollisemmin. Sisällöntuottajille se tuntuu kuin joku penkoisi digitaalista ullakkoa.
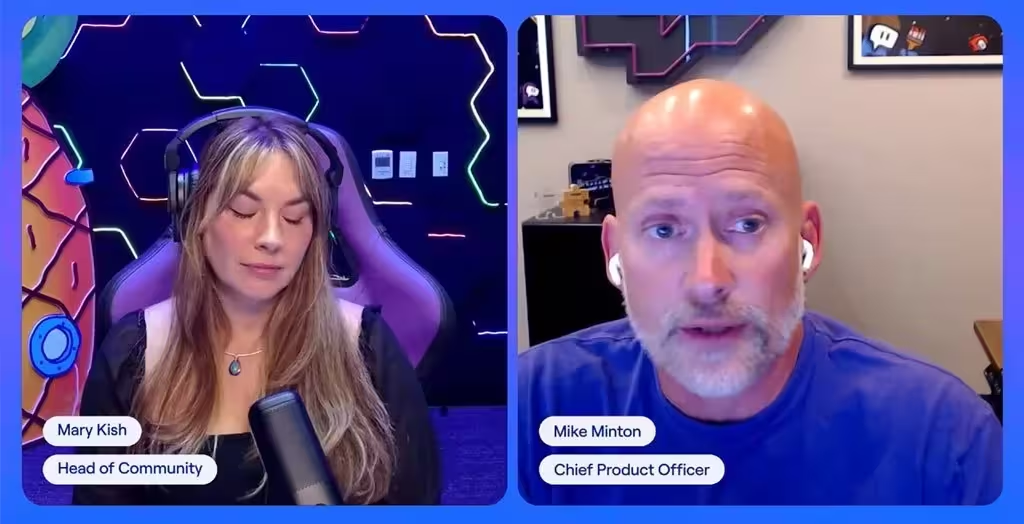
Menneet lähetyksesi saattavat opettaa seuraavaa tekoälysukupolvea puhumaan, näyttämään ja reagoimaan.
Amazon sanoo, että sisällöntuottajat voivat kieltäytyä käytöstä. Mutta valinta on oletuksena päällä. Monet striimaajat huomaavat muutoksen vasta, kun käyttöehtojen päivitys vilahtaa tai kiivas keskustelu räjähtää yrityksen lähetyksessä. Tällainen reaktio on jo nähty: tuore Twitch-lähetys, jossa alustajohtajia oli paikalla, sai chatissa tuhansia vihaisia vastauksia, mikä kertoo selvästi siitä, kuinka herkästi yhteisö reagoi.
On laajempi huoli, ettei tämä ole yksittäistapaus. Striimaajat kysyvät, napattiinko heidän vanhat arkistonsa talteen jo kauan ennen ilmoitusta. Teknologiajätit yleensä kiistävät laittoman keruun, mutta kielelliset ja monimuotoiset mallit ovat selvästi koulutettu valtavalla määrällä verkkomateriaalia, kuten kuvia, kirjoja ja videoita, ja nyt myös suorat lähetykset näyttävät olevan mukana.
Mitä sisällöntuottajien pitäisi siis tehdä? Tarkista asetuksesi. Lue pienet kirjaimet. Päätä, haluatko sisältösi olevan generatiivisten järjestelmien ruokaa. Pyydä alustoja selkeämmiksi ja ennakoiviksi suostumusprosesseiksi sen sijaan, että vaihtoehdot piilotettaisiin valintojen alle. Kiista siitä, kuka omistaa verkon huomion, on kaukana ratkenneesta, mutta lähetykseen meneville kysymys muuttuu äkkiä hyvin henkilökohtaiseksi.

"Minua kiehtoo mobiililaitteet ja älypuhelimien kehitys. Kirjoitan artikkeleita uusista laitteista, testeistä ja käyttäjäkokemuksista."
Keskustelu
Jätä kommentti
Kommentit
Ei vielä kommentteja. Ole ensimmäinen.